Separazione audio per lo sport · Live per enterprise
Rimuovi il rumore di fondo dall'audio sportivo, in diretta
La telecronaca su uno stem. Stadio, pubblico e motori sull'altro. In tempo reale o dopo il fischio finale.

Live
Il tuo feed live, restituito come due stream in tempo reale. Enterprise, su richiestaBatch
Registrazioni e archivi, in Studio o via API
Trasmissioni sportive live con CAMB.AI


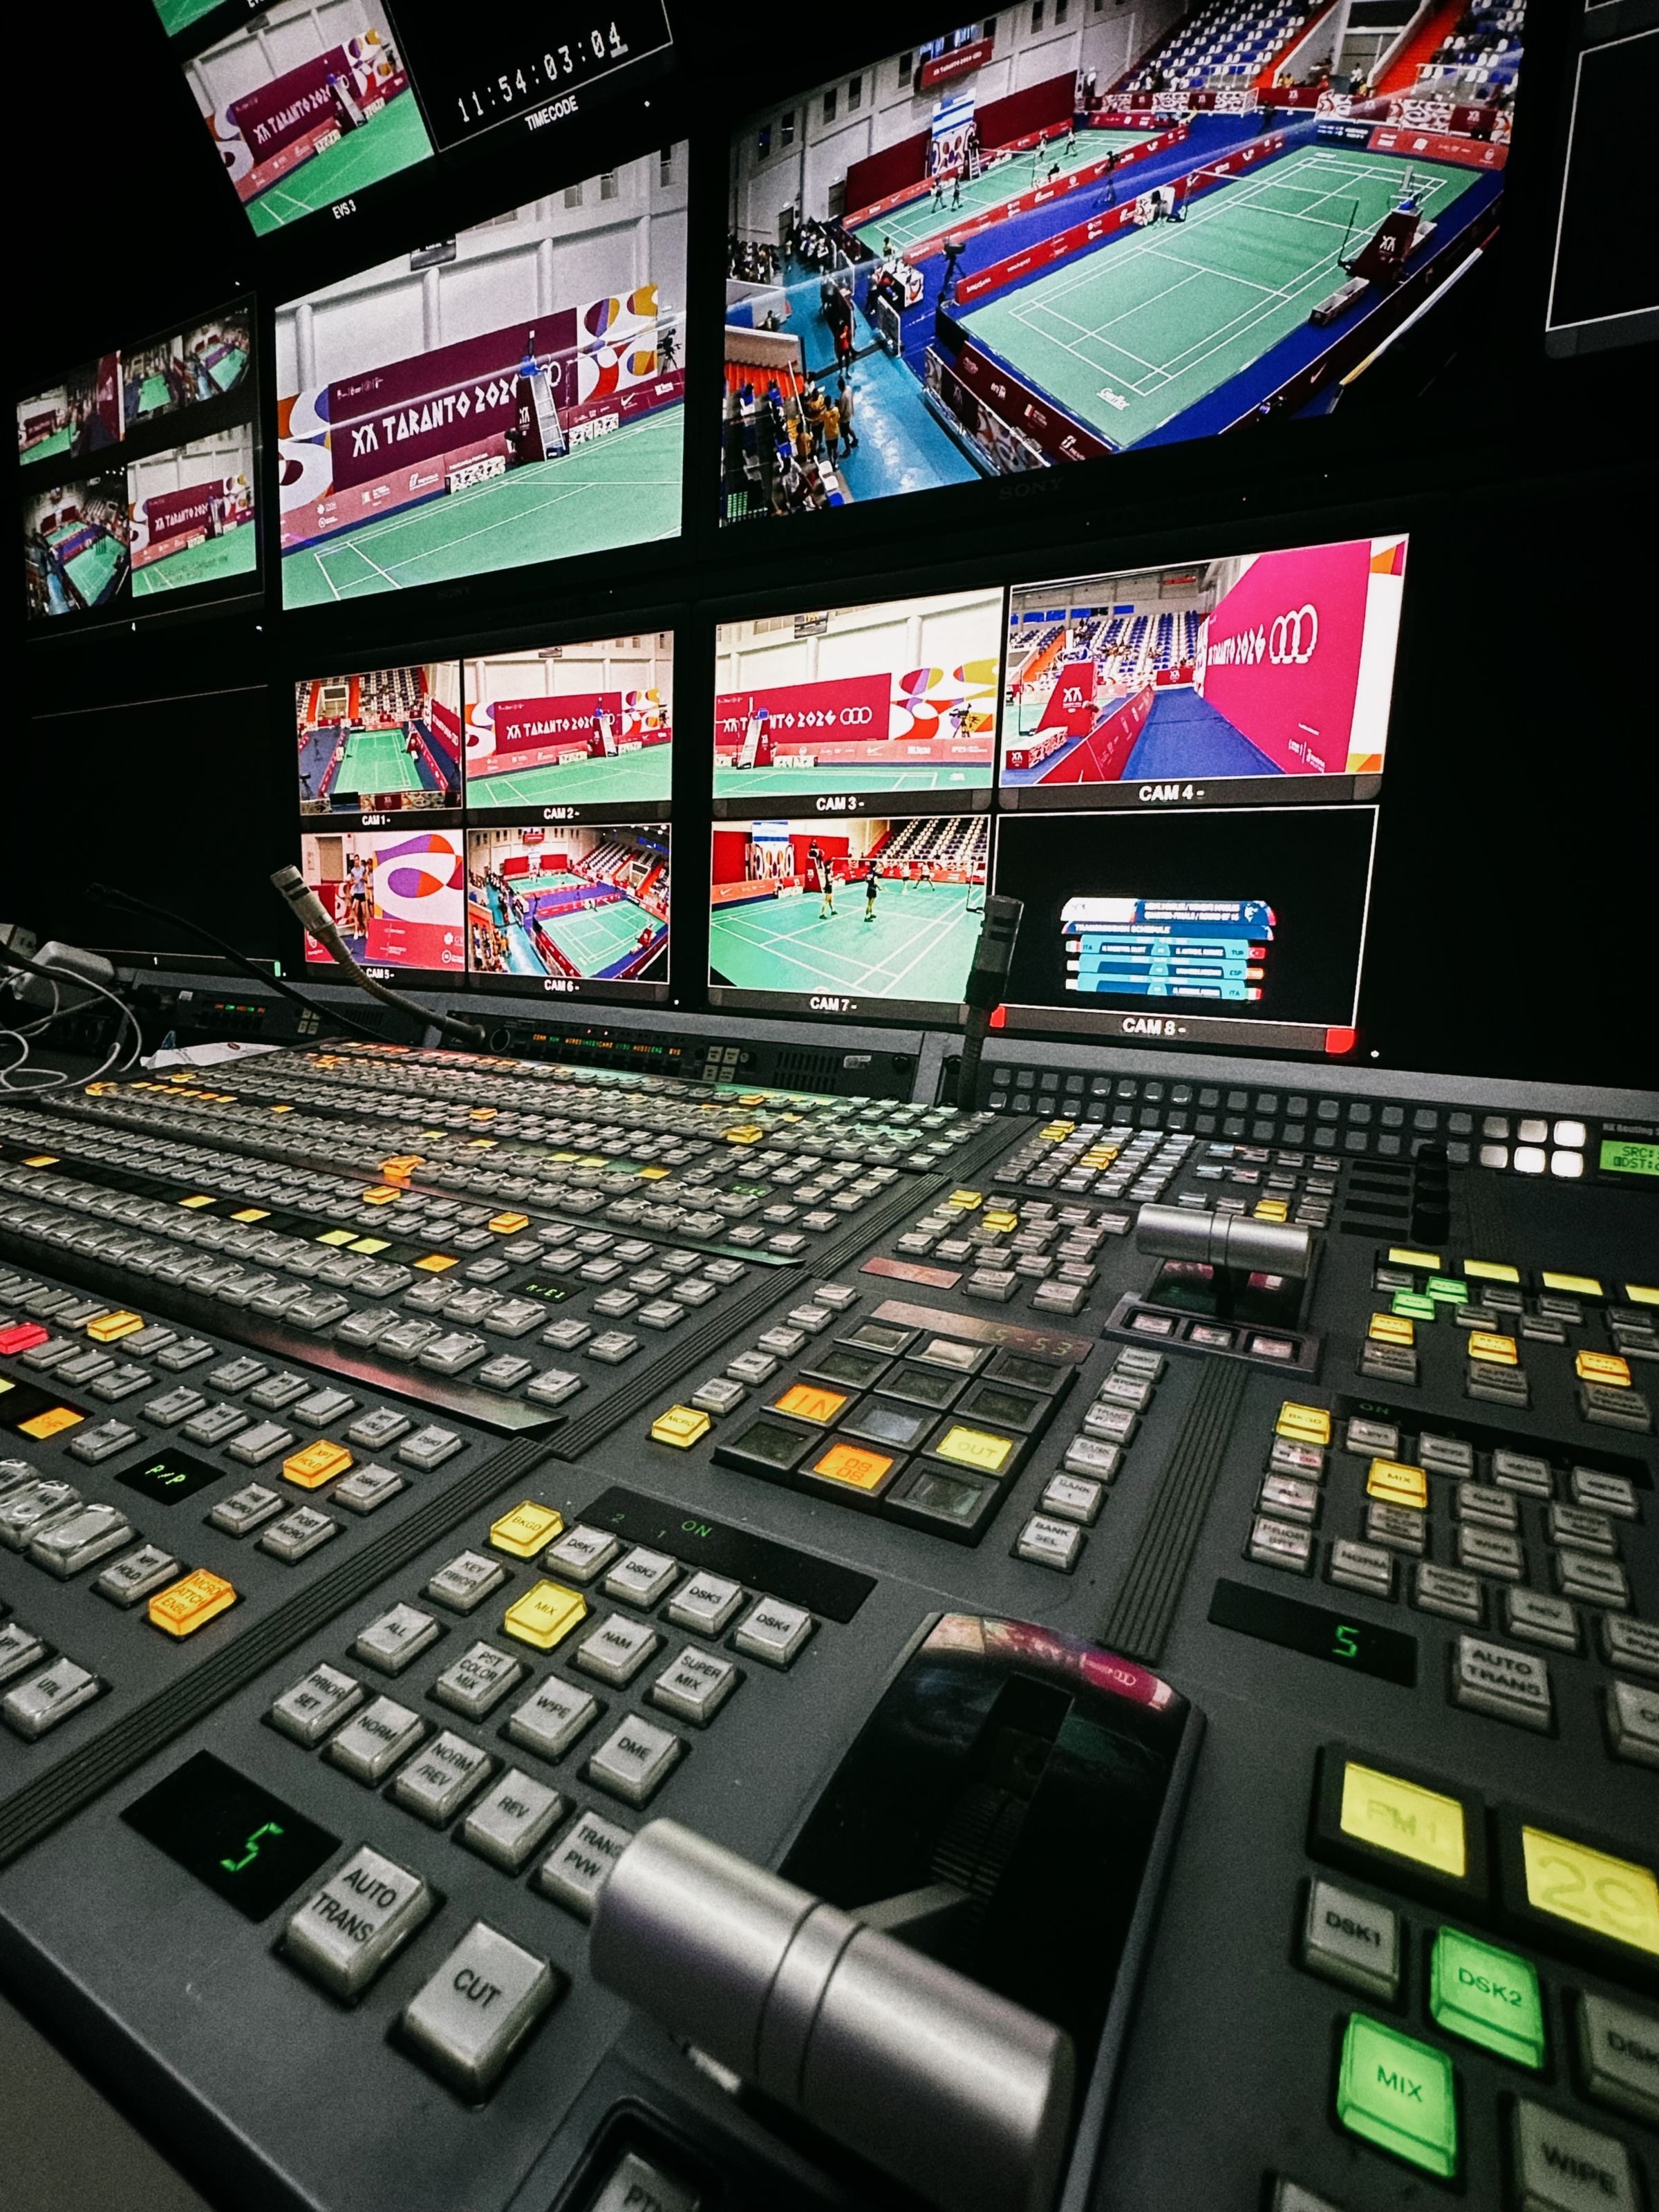
CAMB.AI gestisce trasmissioni live multilingue per la Major League Soccer e l'Australian Open. La separazione audio aggiunge telecronaca pulita e atmosfera allo stesso flusso di lavoro live. Scopri il nostro lavoro nello sport
Pensato per
Dallo stadio all'archivio
Leghe e titolari dei diritti
Telecronaca pulita per ogni mercato, e l'atmosfera per i partner che aggiungono la propria.
Emittenti
Feed internazionali senza telecronaca, e una voce pulita per la traduzione live.
Case di produzione
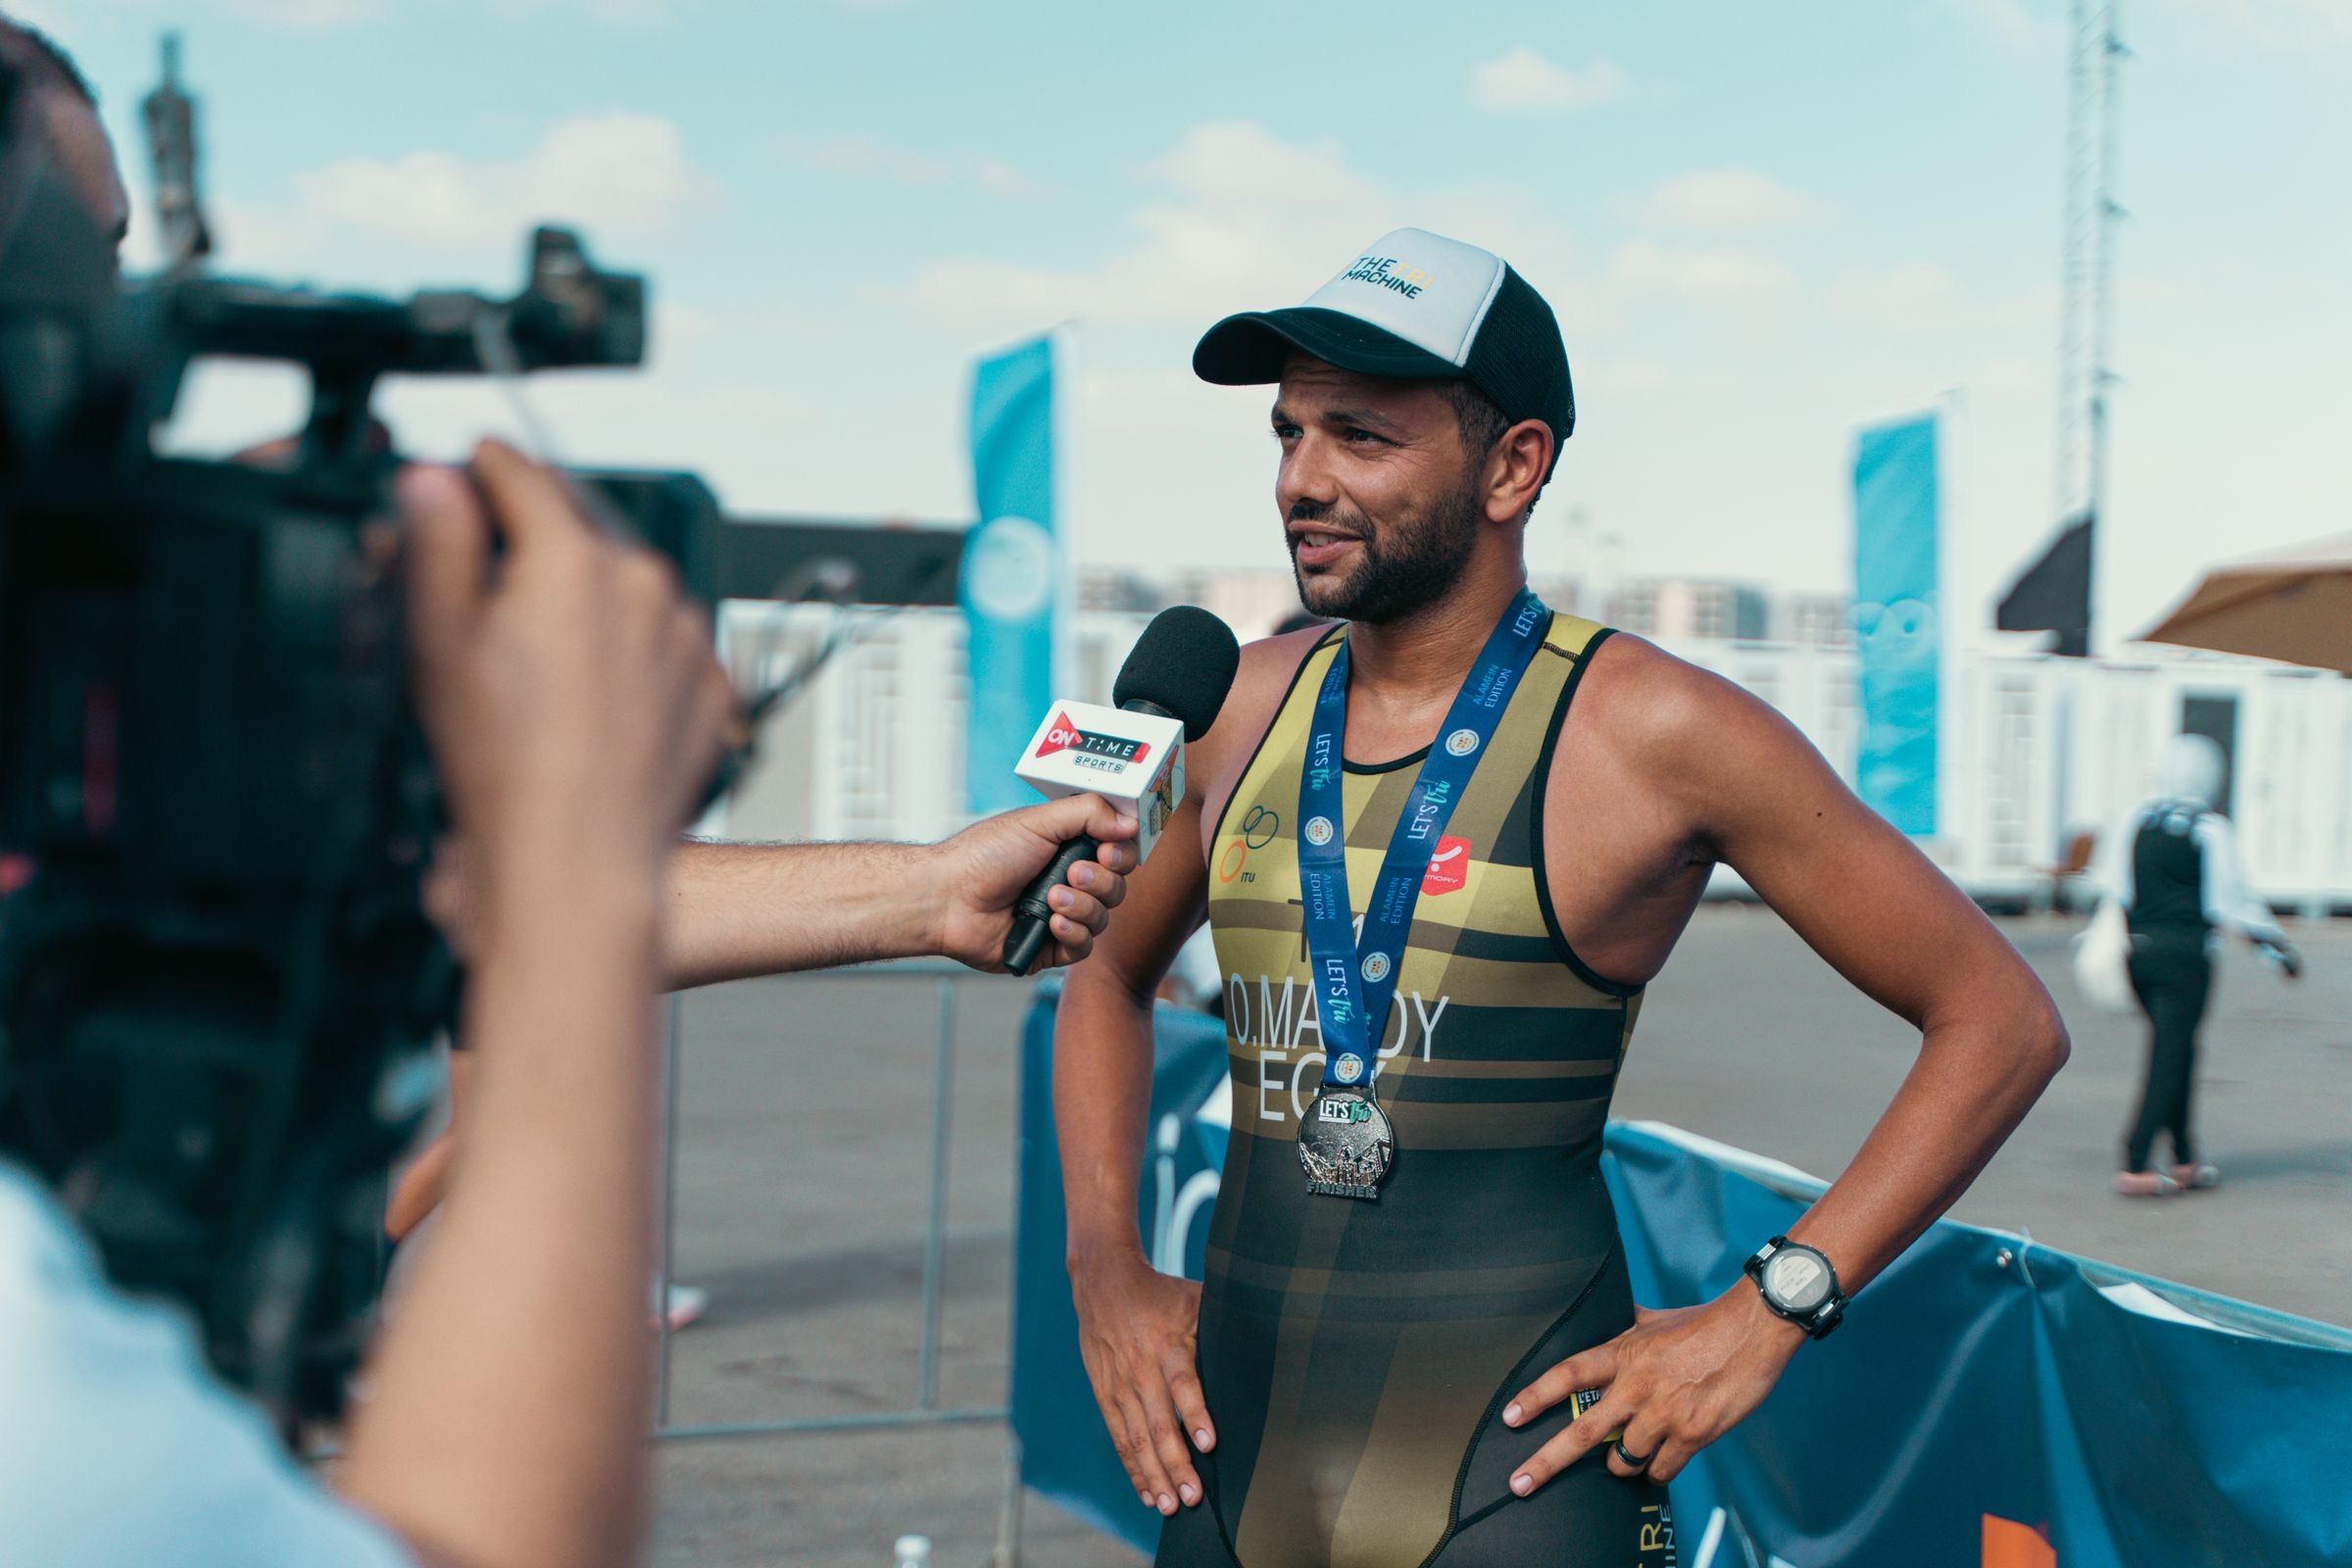
Interviste a bordo campo, nel tunnel e in mixed zone, abbastanza pulite da pubblicare.
Motorsport
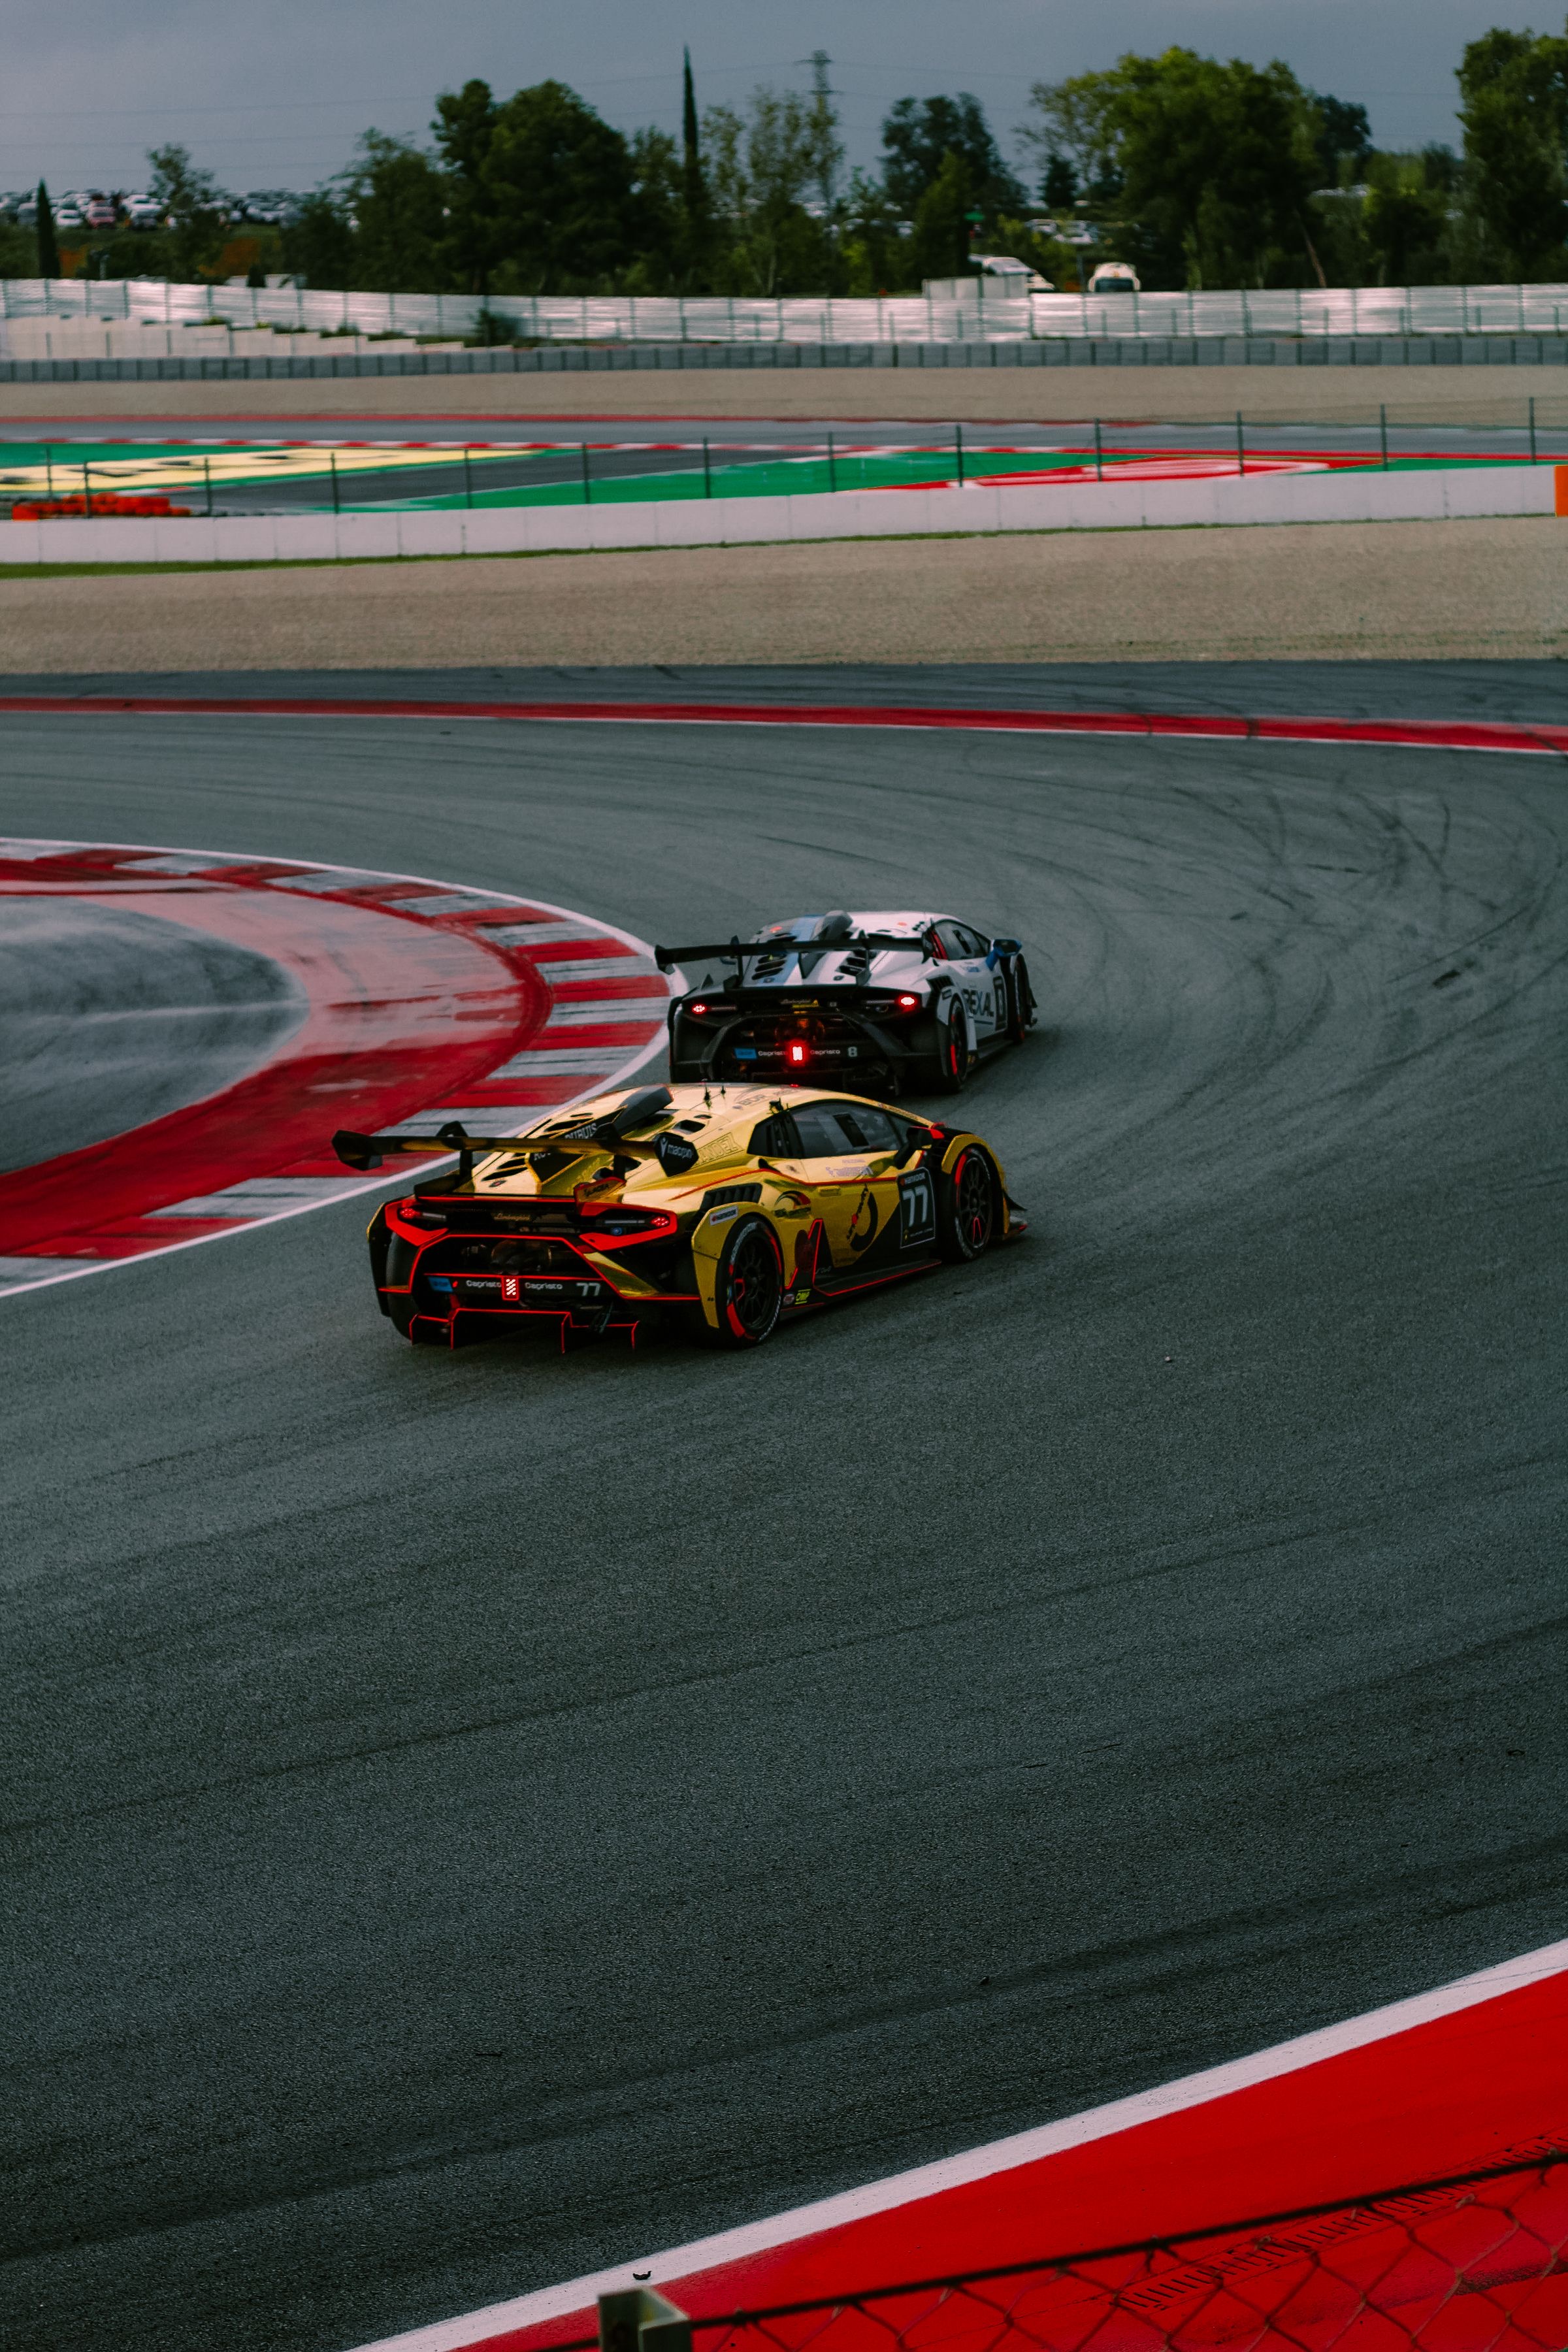
Rumore di motori, vento e pit lane fuori dalle voci di piloti e inviati.
Archivi
Vecchie partite e highlight rimontati con telecronaca pulita.
Il problema
I momenti migliori sono i più rumorosi
Gol, arrivi e pit stop avvengono quando pubblico e motori sono al massimo. È proprio allora che telecronaca, interviste e team radio vengono coperti.
Rimuovere il rumore del pubblico ti restituisce la voce senza perdere il momento.
Separazione vs riduzione del rumore
Separa la voce. Non limitarti ad abbassare il rumore.
| Riduzione del rumore | Separazione audio CAMB.AI | |
|---|---|---|
| Cosa ottieni | Una traccia ripulita | Due stem: telecronaca e atmosfera |
| Pubblico e motori | Abbassati nella stessa traccia | Su uno stem a parte, pronti per il remix |
| Usare l'atmosfera | No | Sì |
Fianco a fianco
Più pulito di AudioShake ed ElevenLabs in tutte le 8 misure
Tocca uno stem per ascoltarlo
Meno rumore tra le parole
vs AudioShake
vs ElevenLabs
Qualità
Testato su audio reale
Nel nostro benchmark su sette clip reali, tra cui TV in diretta e interviste all'aperto, CAMB.AI ha lasciato meno voce nello stem di sottofondo: 0,376%, contro 0,437% di AudioShake e 0,447% di ElevenLabs.
La minor quantità di voce rimasta
14% in meno di AudioShake, 16% in meno di ElevenLabs, 29% in meno di LALAL.AI: uno stem di sottofondo davvero riutilizzabile.
Probabilità media che il parlato si senta ancora nello stem di sottofondo.
La voce più pulita delle quattro
2,8× AudioShake e 1,7× ElevenLabs per la pulizia con cui la voce viene estratta dal mix.
SI-SDR, stimato da SQUIM: quanta parte della voce separata è davvero voce e non ciò che la circondava.
La minor quantità di voce rimasta
14% in meno di AudioShake, 16% in meno di ElevenLabs, 29% in meno di LALAL.AI: uno stem di sottofondo davvero riutilizzabile.
Probabilità media che il parlato si senta ancora nello stem di sottofondo.
La voce che suona meglio
24% sopra AudioShake e 23% sopra ElevenLabs per la resa della voce separata.
PESQ, stimato da SQUIM: qualità percepita del parlato, senza registrazione di riferimento.
La voce più facile da capire
Ogni parola resta chiara, davanti a tutti e tre.
STOI, stimato da SQUIM: quanto è intelligibile il parlato separato.
Più voce nello stem vocale
23% sopra AudioShake e 13% sopra ElevenLabs.
Scarto medio di focus sul parlato CLAP: quanto lo stem in primo piano è chiaramente parlato.
| Misura | CAMB.AI | AudioShake | ElevenLabs | LALAL.AI |
|---|---|---|---|---|
| Qualità di separazione (SI-SDR) | 2.84 dB | 1.01 dB | 1.64 dB | 2.81 dB |
| Voce rimasta nel sottofondo (Leakage) | 0.376% | 0.437% | 0.447% | 0.529% |
| Qualità percepita (PESQ) | 1.895 | 1.527 | 1.544 | 1.852 |
| Intelligibilità (STOI) | 0.744 | 0.697 | 0.726 | 0.740 |
| Voce mantenuta in primo piano (CLAP gap) | 0.258 | 0.209 | 0.229 | 0.255 |
| Qualità del parlato DNSMOS (SIG) | 2.662 | 2.387 | 2.523 | 2.684 |
| Qualità del sottofondo DNSMOS (BAK) | 2.884 | 2.307 | 2.538 | 2.973 |
| Qualità complessiva DNSMOS (OVRL) | 2.303 | 1.923 | 2.094 | 2.327 |
Benchmark interno: CAMB.AI, AudioShake, ElevenLabs e LALAL.AI sulle stesse sette clip da Wikimedia Commons (telecronaca di gaming, un trailer cinematografico, musica dal vivo, un'intervista all'aperto, una redazione in diretta, TV d'archivio e un'intervista sul red carpet), in media. SQUIM e DNSMOS sono stime senza riferimento. Nei tre punteggi DNSMOS LALAL.AI è leggermente avanti; CAMB.AI è in testa in tutte le altre misure.
Casi d'uso
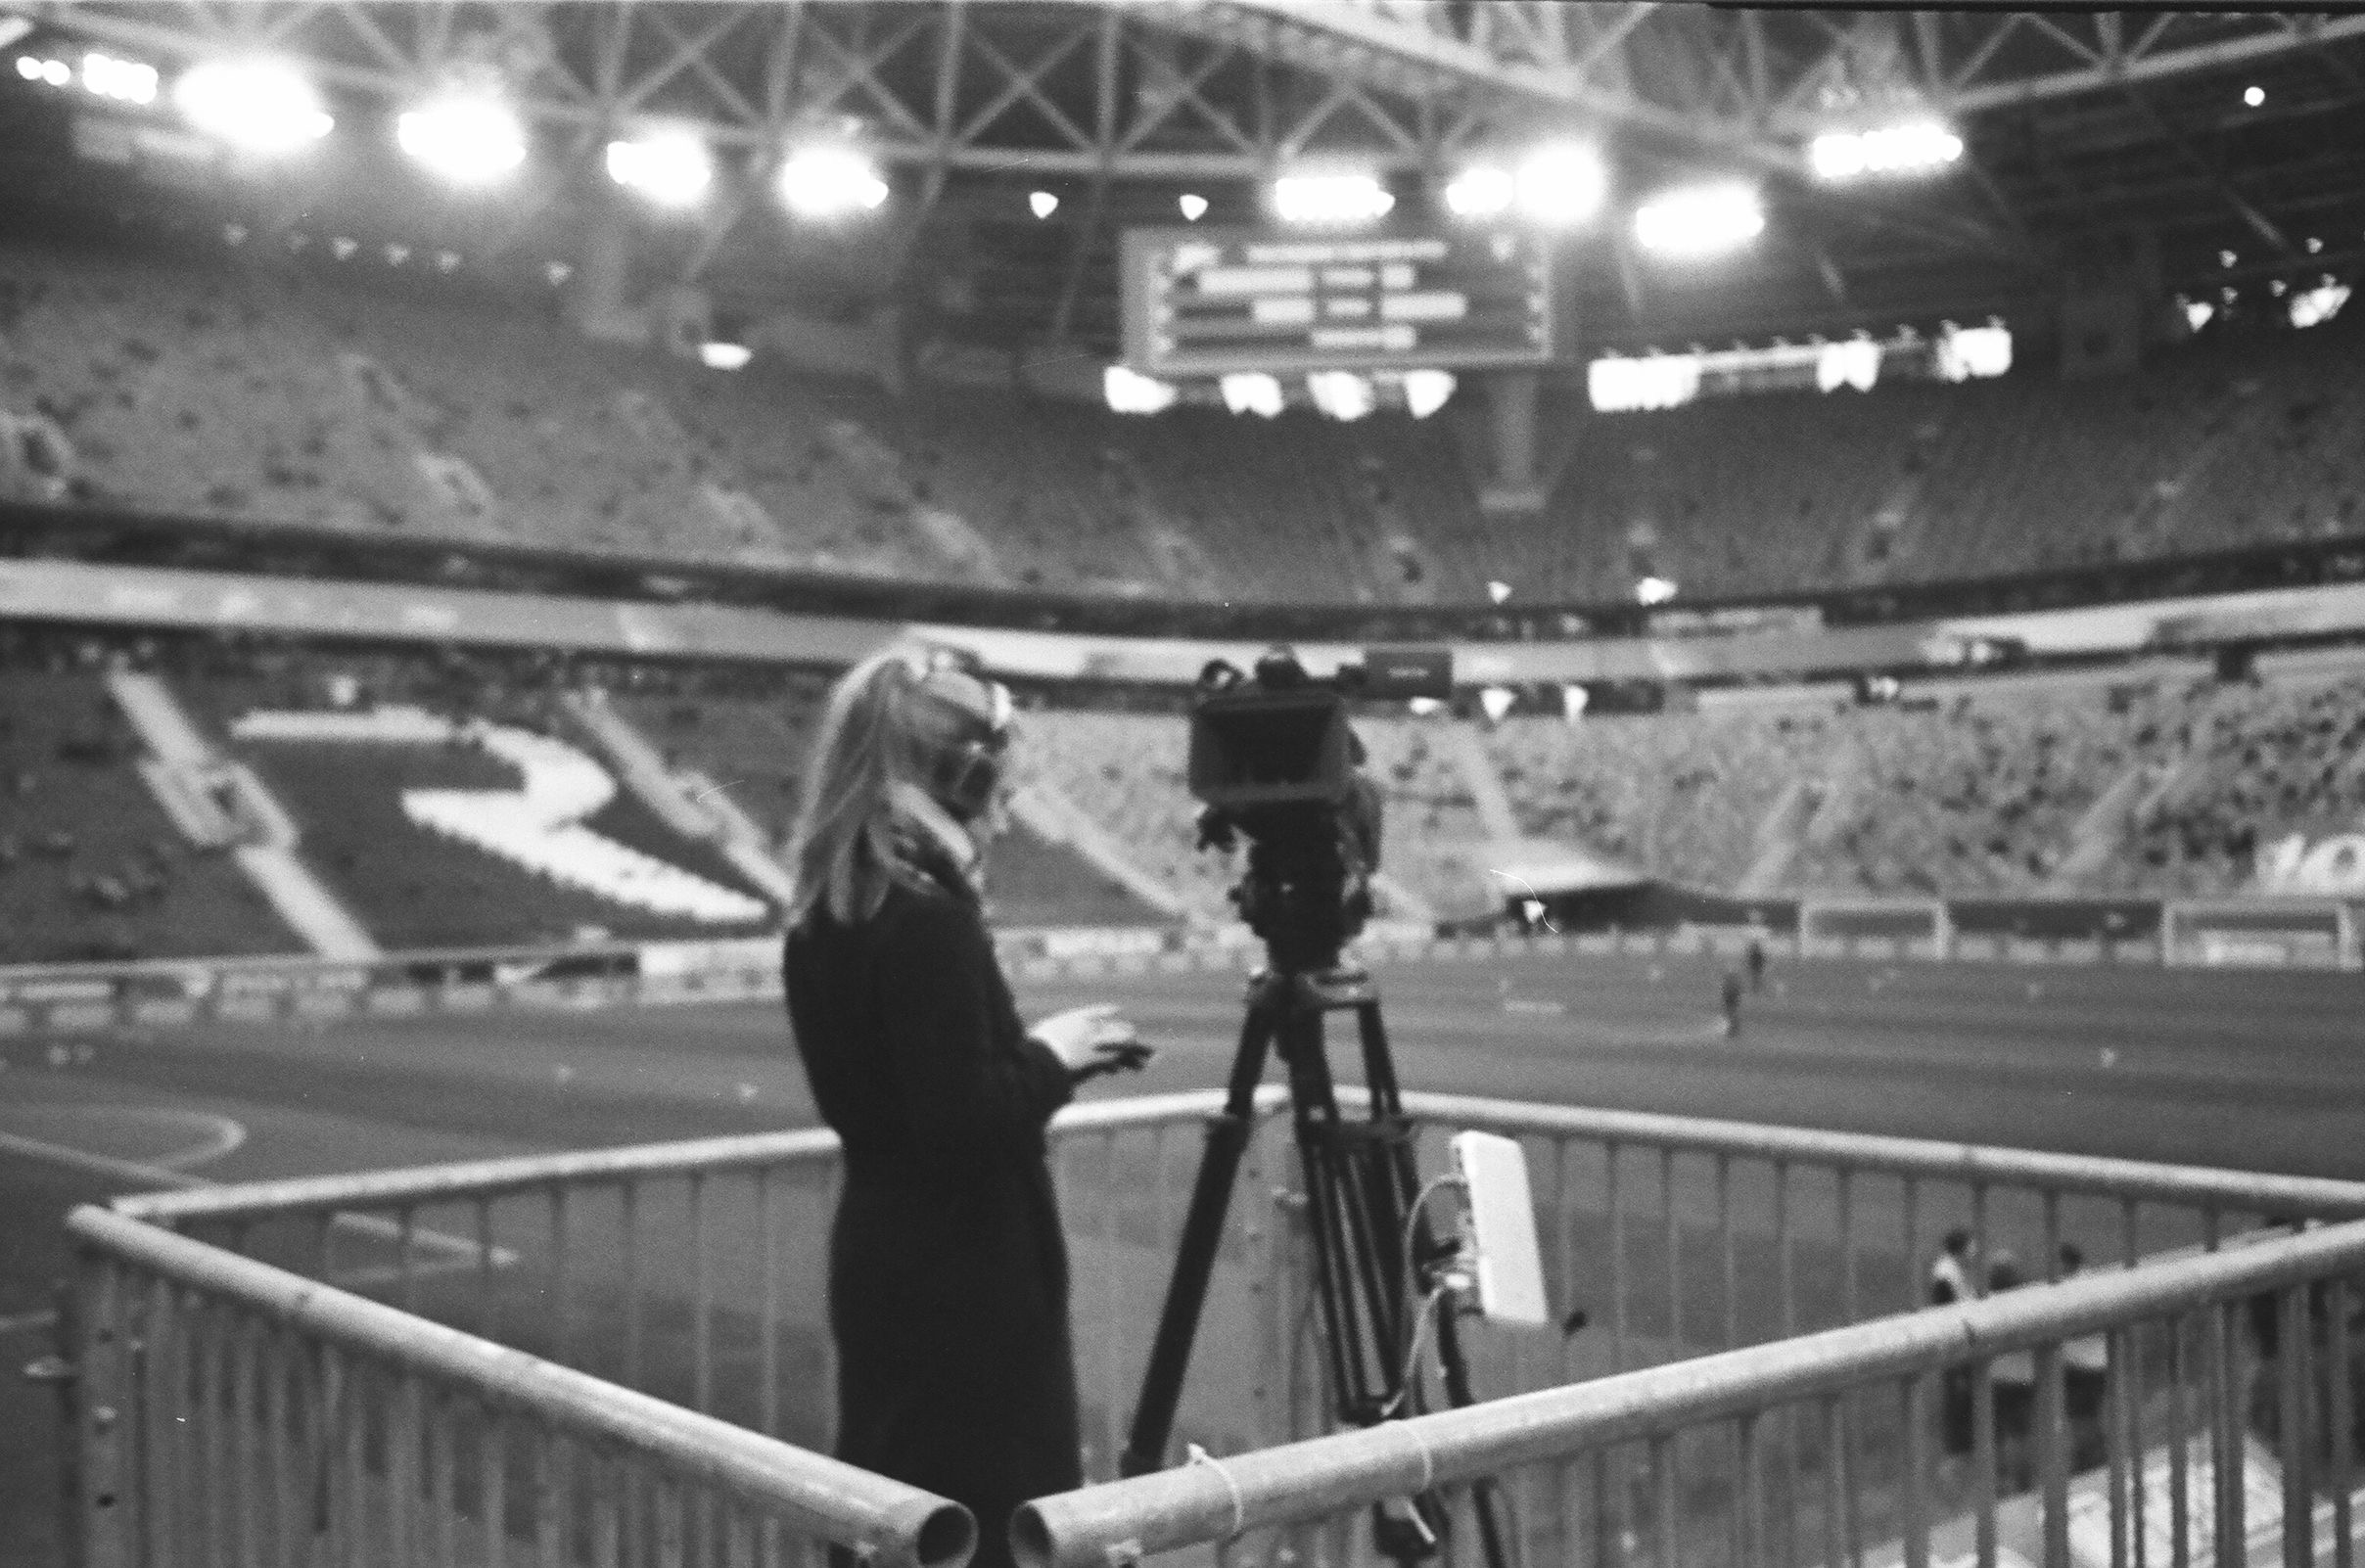
Isolamento della telecronaca, dallo stadio al circuito
Cosa ottieni
Due stem da ogni feed
Voce
Telecronaca, inviati a bordo campo, interviste post-partita, voci di piloti e team.
Atmosfera
Pubblico, cori, motori, speaker e suono dello stadio, senza la voce sopra. Tutto ciò che non è voce resta insieme nello stem d'atmosfera, musica compresa.
Pensato per l'audio dello sport in direttaEnterprise
Il tuo feed live, restituito come voce e atmosfera in due stream separati, in tempo reale. Una funzione enterprise, configurata con il tuo team su richiesta.
Parla con noiDopo la partita
Carica le registrazioni e scarica entrambi gli stem in FLAC, WAV, MP3 o AAC.
API
Automatizzalo nel tuo flusso di produzione.
POST /apis/audio-separationGET /apis/audio-separation/{task_id}GET /apis/audio-separation-result/{run_id}POST /apis/audio-separation-resultsScopri l'API di separazione audio
Altre soluzioni di separazione audio
Come funziona
Rimuovere il rumore di fondo dall'audio in tre passaggi
Prezzi
Scegli le tue ore. Entrambi gli stem in ogni piano.
Ogni piano ti dà la voce e il sottofondo in due stem, in Studio e via API. Prova qualsiasi piano gratis per 3 giorni, con 30 minuti di audio.
Solo
$40/mese
$480 fatturati annualmente
3 ore di audio al mese
Per creator e appassionati. Estrai la voce da canzoni, podcast e video in pochi minuti.
Inizia la prova gratuita- Oggi 30 minuti per provare. Oggi $0.
- Giorno 3 Il piano parte: $480 all’anno.
Session
Consigliato$130/mese
$1,560 fatturati annualmente
10 ore di audio al mese
Per produttori e content creator che lavorano ogni settimana. Abbastanza per album interi, podcast e colonne sonore.
Inizia la prova gratuita- Oggi 30 minuti per provare. Oggi $0.
- Giorno 3 Il piano parte: $1,560 all’anno.
Catalog
$375/mese
$4,500 fatturati annualmente
30 ore di audio al mese
Per professionisti e team con grandi volumi. Stem puliti di voce e sottofondo per musica, post-produzione e localizzazione.
Inizia la prova gratuita- Oggi 30 minuti per provare. Oggi $0.
- Giorno 3 Il piano parte: $4,500 all’anno.
Enterprise
Grandi volumi, separazione live sui tuoi feed o separazione dentro il tuo flusso di lavoro.
- Separazione live, in tempo reale
- Prezzi a volume
- SLA e supporto dedicato
- Consegna e archiviazione personalizzate
FAQ
Domande sulla separazione audio per lo sport
Ascolta la tua partita, separata
- Conforme SOC 2
- Il tuo audio non viene usato per addestrare i nostri modelli
- Batch e live