API speech-to-text

API de transcription pour l'audio enregistré et en temps réel

Envoyez un fichier et recevez une transcription avec les noms des locuteurs et les horodatages. Diffusez un audio en direct et obtenez le texte pendant qu'on parle. 150+ langues, détectées automatiquement.

call-en.mp30:13 / 0:13
Python
from camb.client import CambAI​client = CambAI()  # reads CAMB_API_KEYjob = client.transcription.create_transcription(media_url="https://example.com/call-en.mp3",language="auto",)print(job.task_id)
Résultat200 OK

Une seule API pour toutes vos sources de parole

L'API speech-to-text de CAMB.AI transforme la parole en texte grâce à la reconnaissance automatique de la parole (ASR). Envoyez des fichiers enregistrés pour obtenir des transcriptions complètes, ou diffusez l'audio pour un texte en direct. Une seule clé API pour les deux, depuis votre propre code ou depuis Studio.

Vous cherchez une API de reconnaissance vocale qui fonctionne dans votre application, pas seulement dans le navigateur ? La voici.

Fichiers enregistrés ou audio en temps réel

Par lots

API de transcription pour fichiers enregistrés

Importez un fichier ou envoyez une URL. Recevez le texte découpé par locuteur, avec les heures de début et de fin de chaque ligne. Exportez en JSON, SRT, VTT ou TXT.

Imports jusqu'à 20 MB. Pour les enregistrements plus longs, envoyez une URL.

  • MP3
  • WAV
  • AAC
  • FLAC
  • MP4
  • MOV

Temps réel

API speech-to-text en temps réel via WebSocket

Une API speech-to-text en streaming pour les développeurs : ouvrez un WebSocket, diffusez l'audio brut de votre application et recevez des transcriptions partielles pendant que les gens parlent encore, puis un résultat final avec des horodatages au mot près. Conçue pour les sous-titres en direct, les applications vocales et les agents IA.

  • WebSocket
  • PCM
  • A-law
  • μ-law

Diarisation des locuteurs sur chaque fichier enregistré

L'API identifie qui parle à quel moment et étiquette chaque ligne : Locuteur 1, Locuteur 2. Elle est intégrée aux modes rapide et lent, sans rien à activer : interviews, réunions et podcasts reviennent prêts à lire.

Conçue pour l'audio du monde réel

  • L'audio nettoyé d'abord

    La voix est séparée du bruit de fond avant la transcription, et vous choisissez de garder ou non la musique. Désactivez ce nettoyage pour une parole déjà propre, enregistrée en studio.

  • Détection automatique de la langue

    Réglez la langue sur auto et l'API la détecte pour vous, parmi 150+ langues.

  • Rapide ou approfondi

    Utilisez le mode rapide par défaut, ou le mode lent pour une passe plus approfondie.

  • Sortie prête pour les sous-titres

    Définissez la longueur maximale et la durée d'affichage de chaque ligne, puis exportez en SRT ou VTT.

  • Horodatage au mot près

    Les résultats finaux en temps réel incluent une heure de début et de fin pour chaque mot.

  • Résultats groupés

    Récupérez les transcriptions de nombreuses exécutions en une seule requête.

La transcription à l'échelle du broadcast

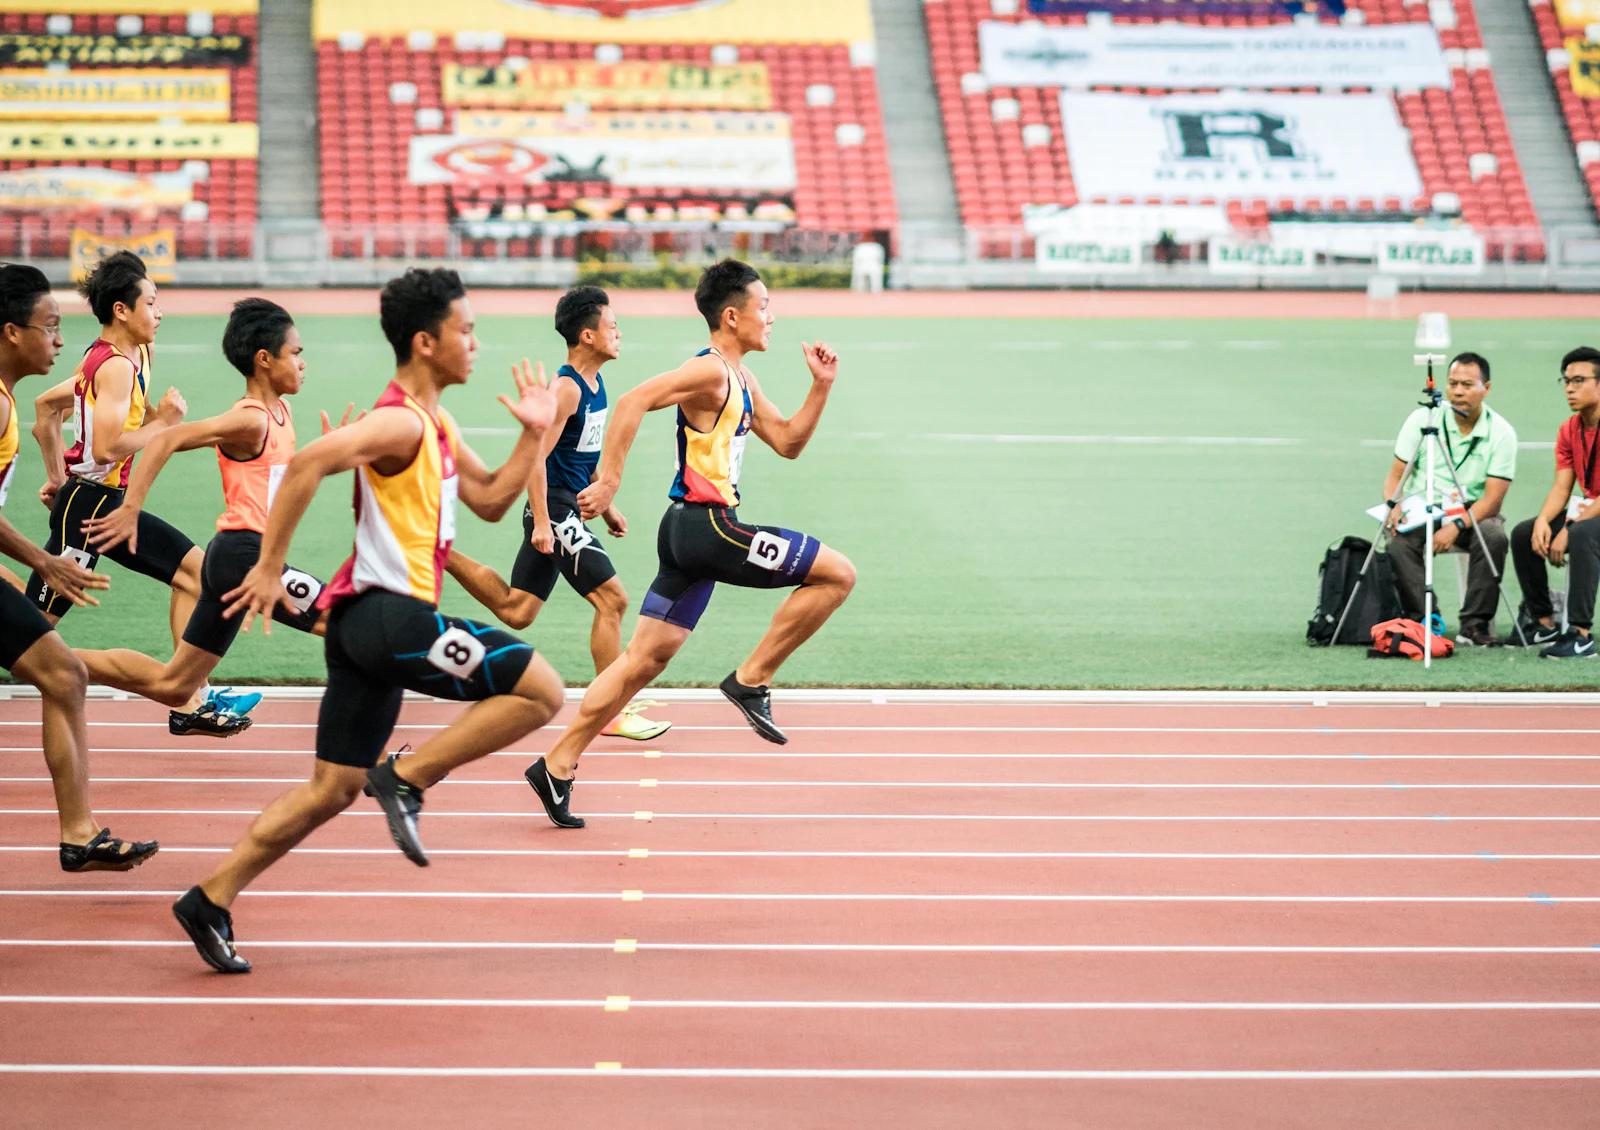
Sprinters racing on an athletics track

Speech-to-text en temps réel pour les Jeux paralympiques d'hiver de Milan Cortina 2026

“En proposant des sous-titres en temps réel pour chaque épreuve sur Eurovision Sport, nous développons l'accessibilité numérique et permettons à davantage de personnes de suivre l'action en direct.”

Alan Fagan, directeur général, Eurovision Sport
6
sports paralympiques sous-titrés en temps réel
10 jours
de couverture en direct et à la demande, du 6 au 15 mars 2026
2024
début du partenariat, d'abord avec European Athletics

Lire l'étude de cas

API speech-to-text en Python et TypeScript

Installez le SDK, ajoutez votre clé API et envoyez votre premier fichier. SDK pour Python et TypeScript (JavaScript), plus Go, Java, Rust et PHP pour les fichiers enregistrés.

  • Python
  • TypeScript
  • Go
  • Java
  • Rust
  • PHP

Lire la documentation

from camb.client import CambAI​client = CambAI()  # reads CAMB_API_KEYjob = client.transcription.create_transcription(media_url="https://example.com/meeting.mp3",language="auto",)print(job.task_id)
Réponse200 OK
{ "transcript": [{ "start": 5.0, "end": 12.0,"text": "Welcome to our discussion on AI.","speaker": "SPEAKER_0" },{ "start": 13.0, "end": 18.0,"text": "Thank you for having me.","speaker": "SPEAKER_1" }] }

Transcrivez une fois, utilisez partout

Votre transcription ne s'arrête pas au texte. Sur CAMB.AI, la même transcription peut devenir des sous-titres, une traduction ou une version doublée, sur la même plateforme. Besoin de transcriptions sans écrire de code, à partir d'un fichier ou en direct depuis votre micro ? Utilisez notre outil de transcription dans Studio.

Questions sur l'API speech-to-text

Une API speech-to-text (aussi appelée API de transcription ou API voix-texte) permet à votre logiciel d'envoyer de l'audio et de recevoir du texte. L'API de CAMB.AI traite les fichiers enregistrés et les flux audio en temps réel.

L'API de transcription par lots traite les fichiers enregistrés : vous envoyez un fichier ou une URL et récupérez la transcription complète une fois prête. L'API en temps réel diffuse l'audio via un WebSocket et renvoie le texte pendant que les gens parlent.

Oui, pour les fichiers enregistrés. Chaque ligne de la transcription reçoit un nom de locuteur (Locuteur 1, Locuteur 2) et une heure de début et de fin. L'API en temps réel ne sépare pas encore les locuteurs.

150+ langues et variantes régionales. Indiquez un code de langue, ou réglez la langue sur auto pour la détecter.

En temps réel, oui : chaque résultat final inclut une heure de début et de fin pour chaque mot. Les fichiers enregistrés renvoient une heure de début et de fin pour chaque ligne de la transcription.

MP3, WAV, AAC, FLAC, MP4 et MOV. Importez des fichiers de moins de 20 MB, ou envoyez une URL pour les enregistrements plus longs. En temps réel, diffusez l'audio brut (PCM, A-law ou μ-law) via le WebSocket.

Oui. Installez camb-sdk avec pip et créez une transcription en quelques lignes. Il existe aussi un SDK TypeScript (@camb-ai/sdk). L'API en temps réel est disponible dans les SDK Python et TypeScript ; les SDK Go, Java, Rust et PHP couvrent les fichiers enregistrés.

Oui. Téléchargez la transcription en SRT, VTT ou TXT avec les noms des locuteurs, et définissez la longueur maximale de chaque ligne de sous-titre.

Par défaut, l'API sépare la voix du bruit de fond avant de transcrire, et vous pouvez aussi choisir de retirer la musique. Un audio propre donne toujours les meilleurs résultats, et vous pouvez désactiver le nettoyage pour une parole de qualité studio.

Envoyez votre premier fichier aujourd'hui

  • Conforme SOC 2
  • Vos exécutions passées restent dans History
  • Fichiers enregistrés et temps réel