Audio-Trennung für Sport · Live für Enterprise
Hintergrundgeräusche aus Sport-Audio entfernen, live
Der Kommentar auf einem Stem. Stadion, Publikum und Motoren auf dem anderen. In Echtzeit oder nach dem Abpfiff.

Live
Ihr Live-Feed, zurück als zwei Streams in Echtzeit. Enterprise, auf AnfrageBatch
Aufnahmen und Archive, in Studio oder per API
Live-Sportübertragungen mit CAMB.AI


CAMB.AI betreut mehrsprachige Live-Übertragungen für die Major League Soccer und die Australian Open. Die Audio-Trennung bringt sauberen Kommentar und Atmosphäre in denselben Live-Workflow. Unsere Arbeit im Sport
Gemacht für
Vom Stadion bis ins Archiv
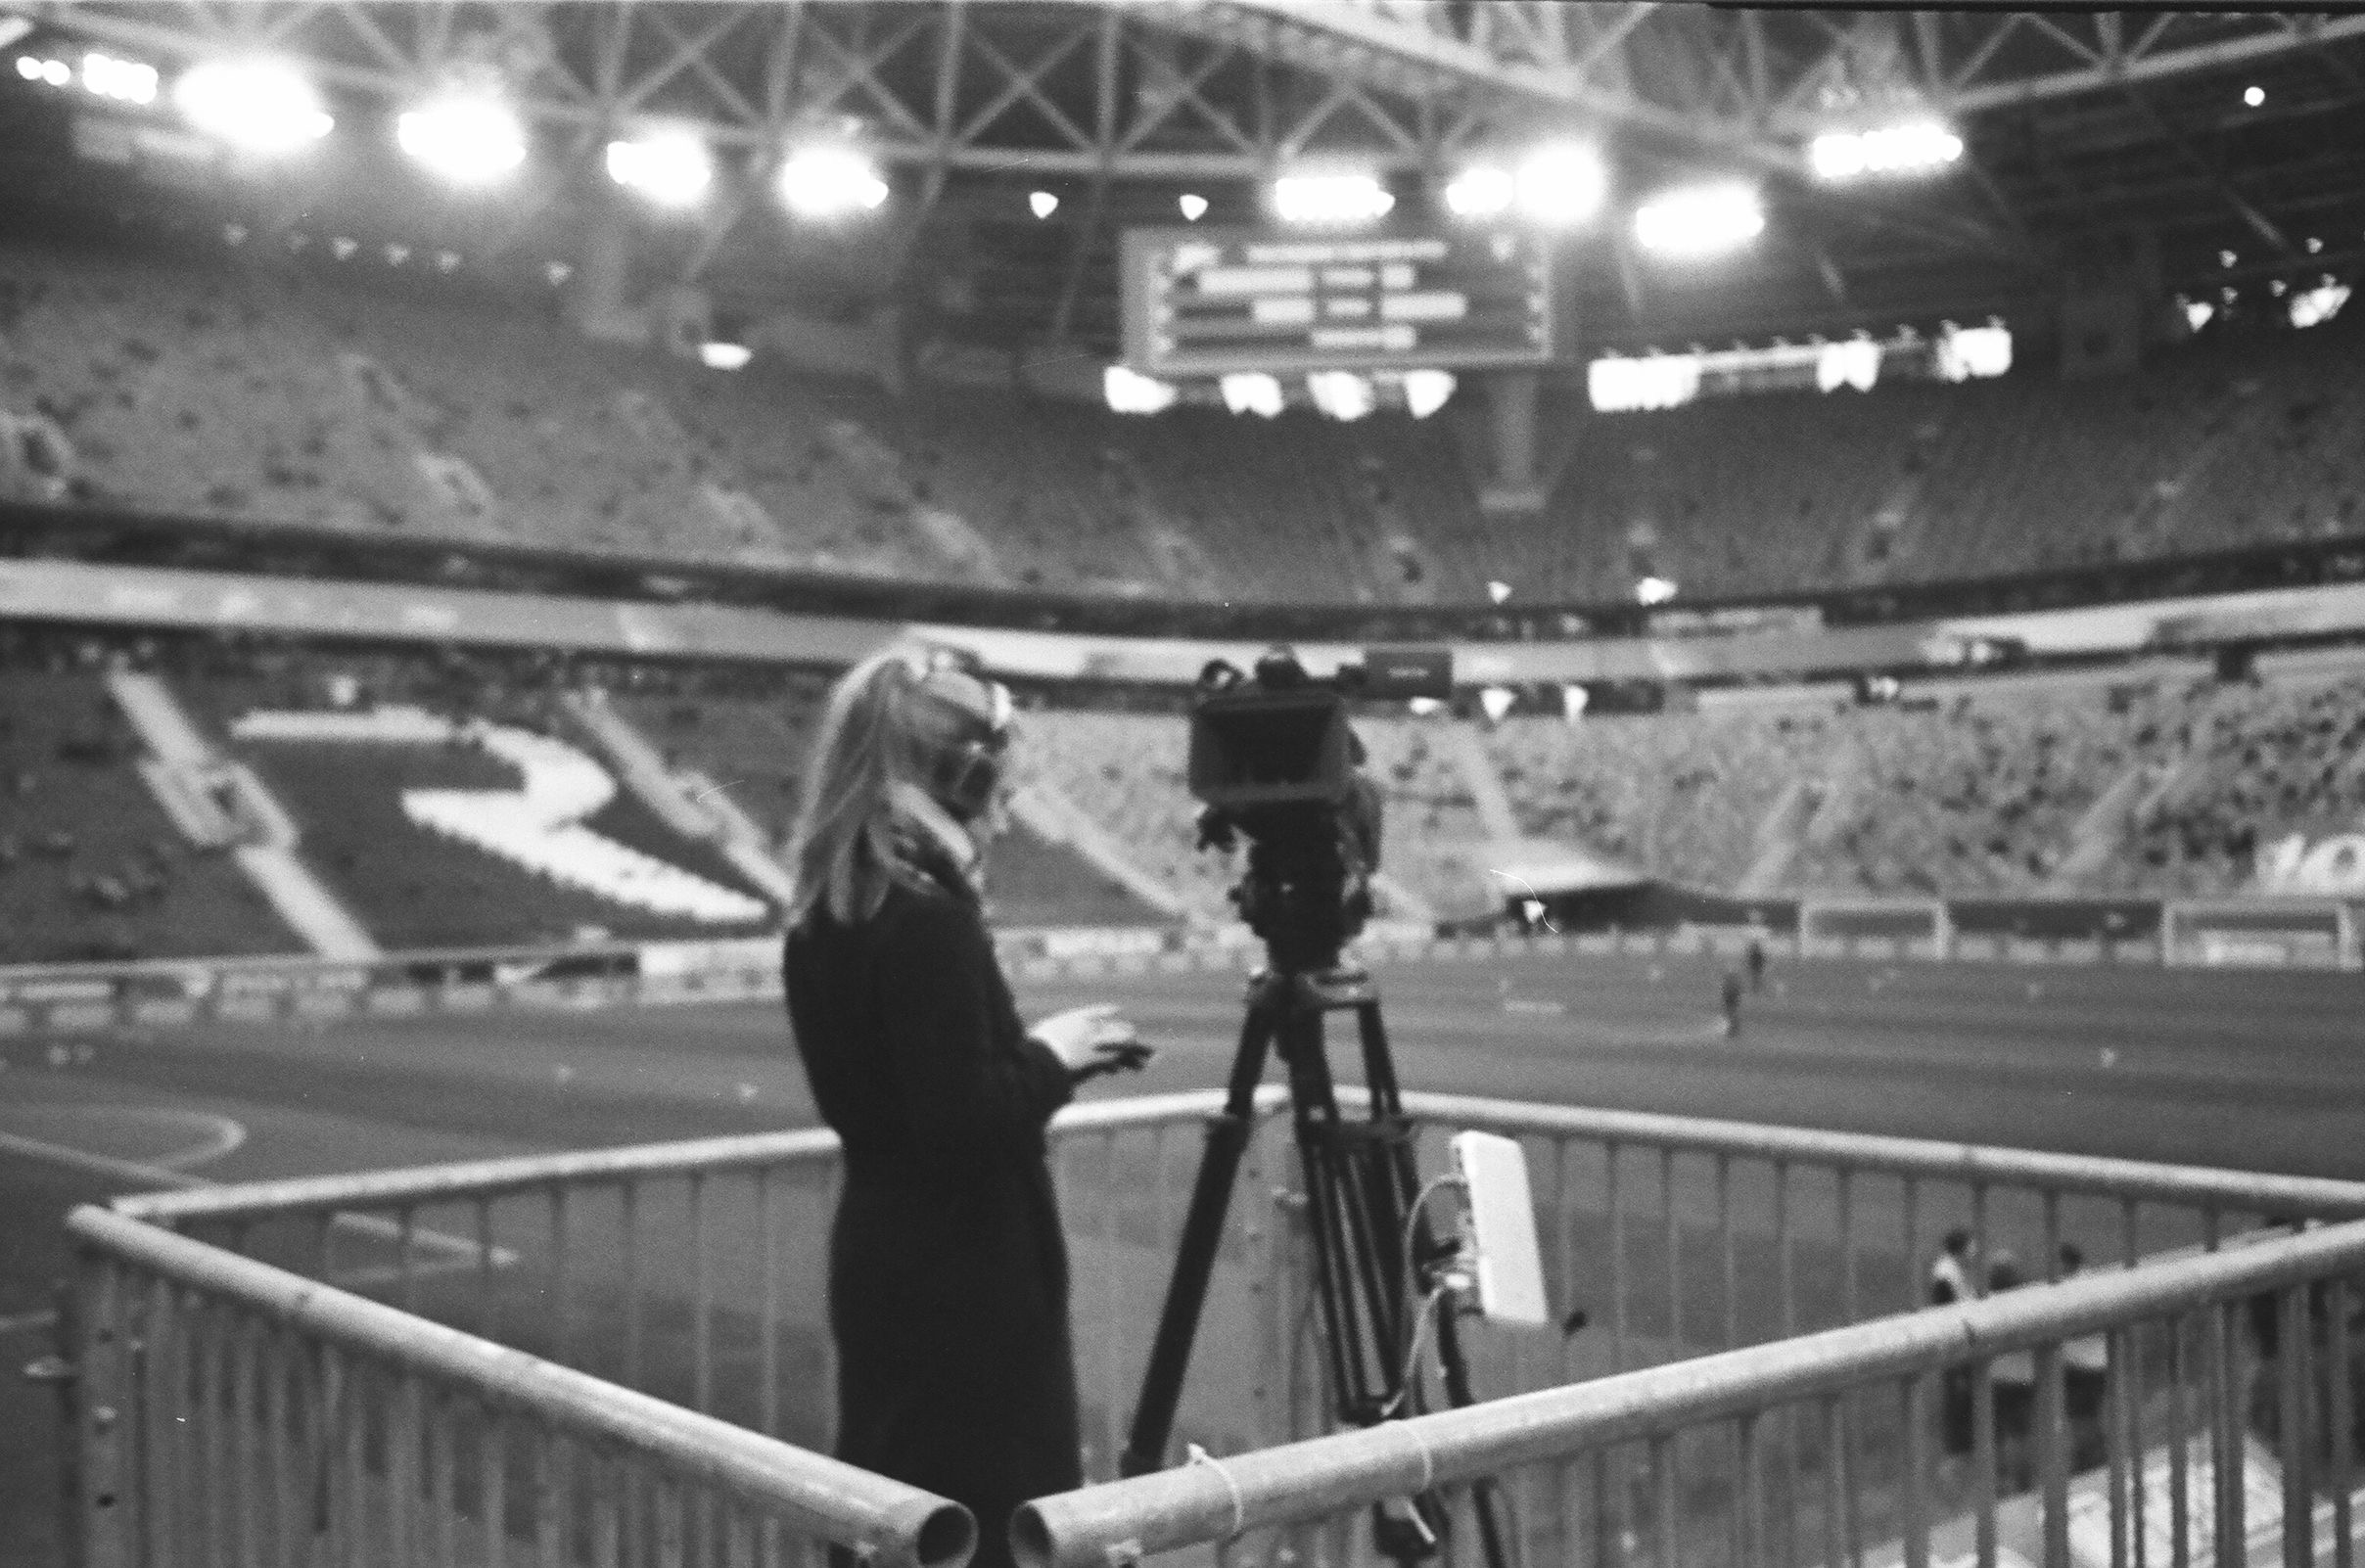
Ligen und Rechteinhaber
Sauberer Kommentar für jeden Markt und die Atmosphäre für Partner, die ihren eigenen hinzufügen.
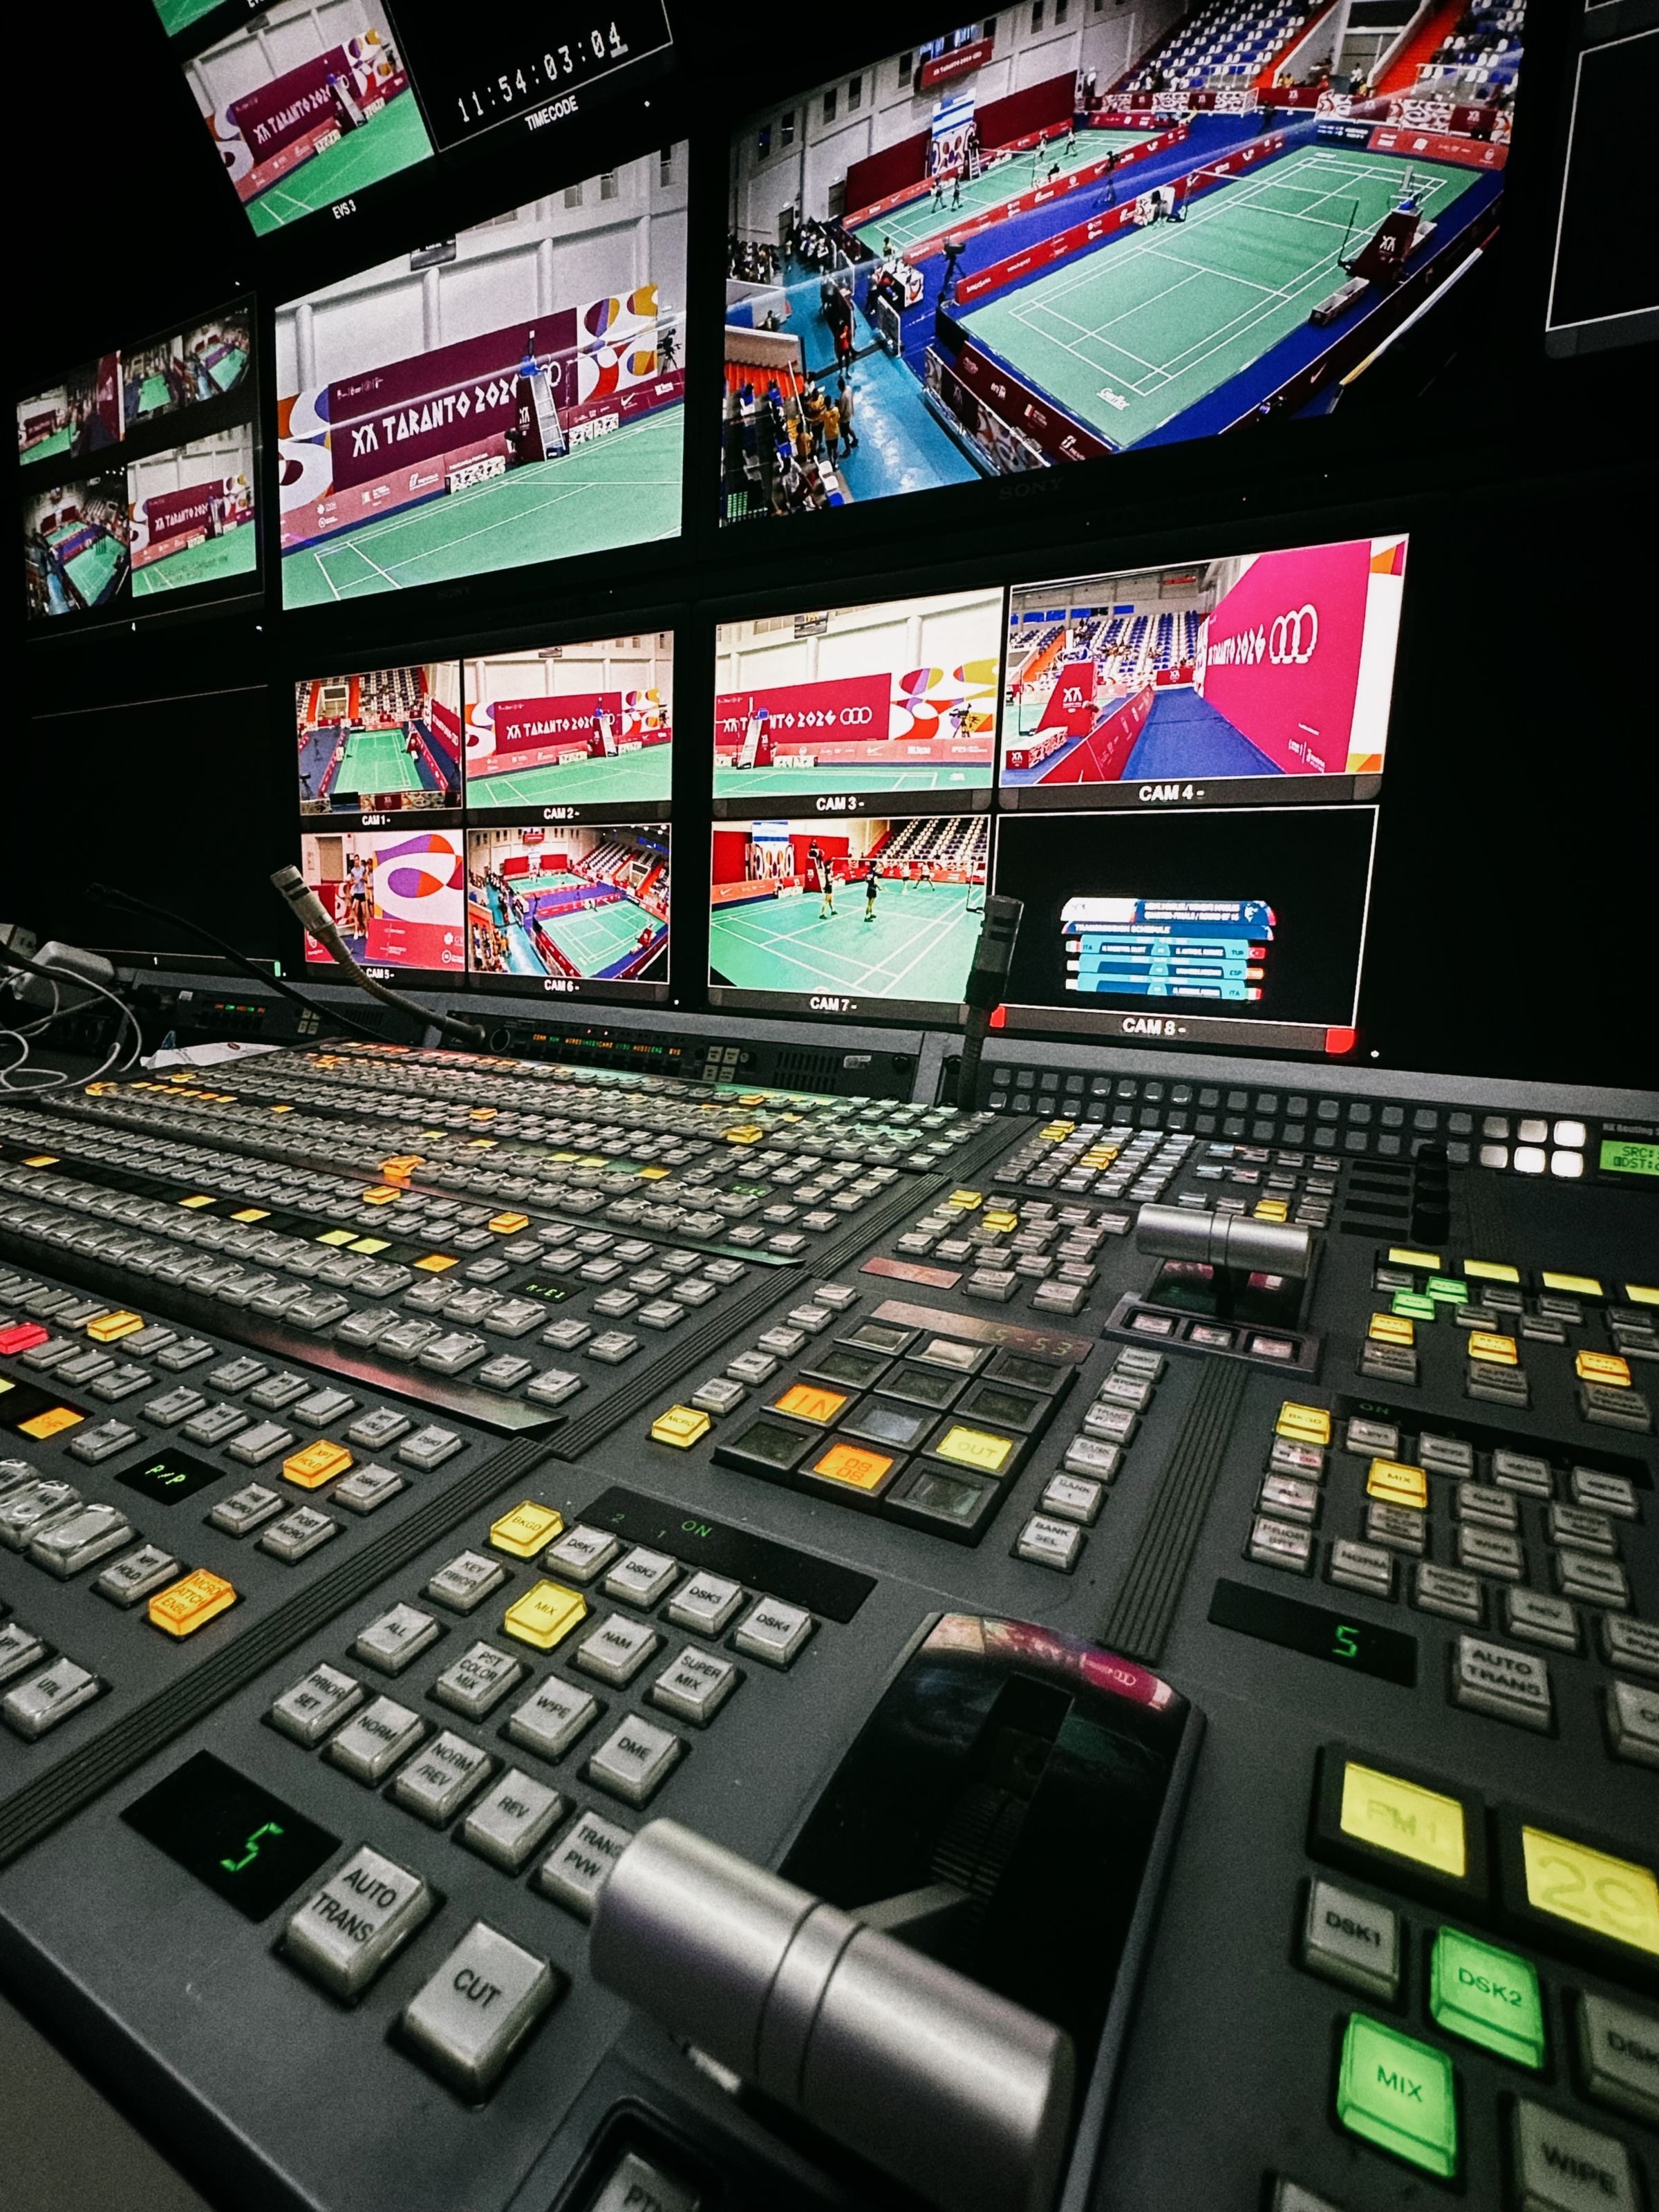
Sender
Weltsignale ohne Kommentar und eine saubere Stimme für die Live-Übersetzung.
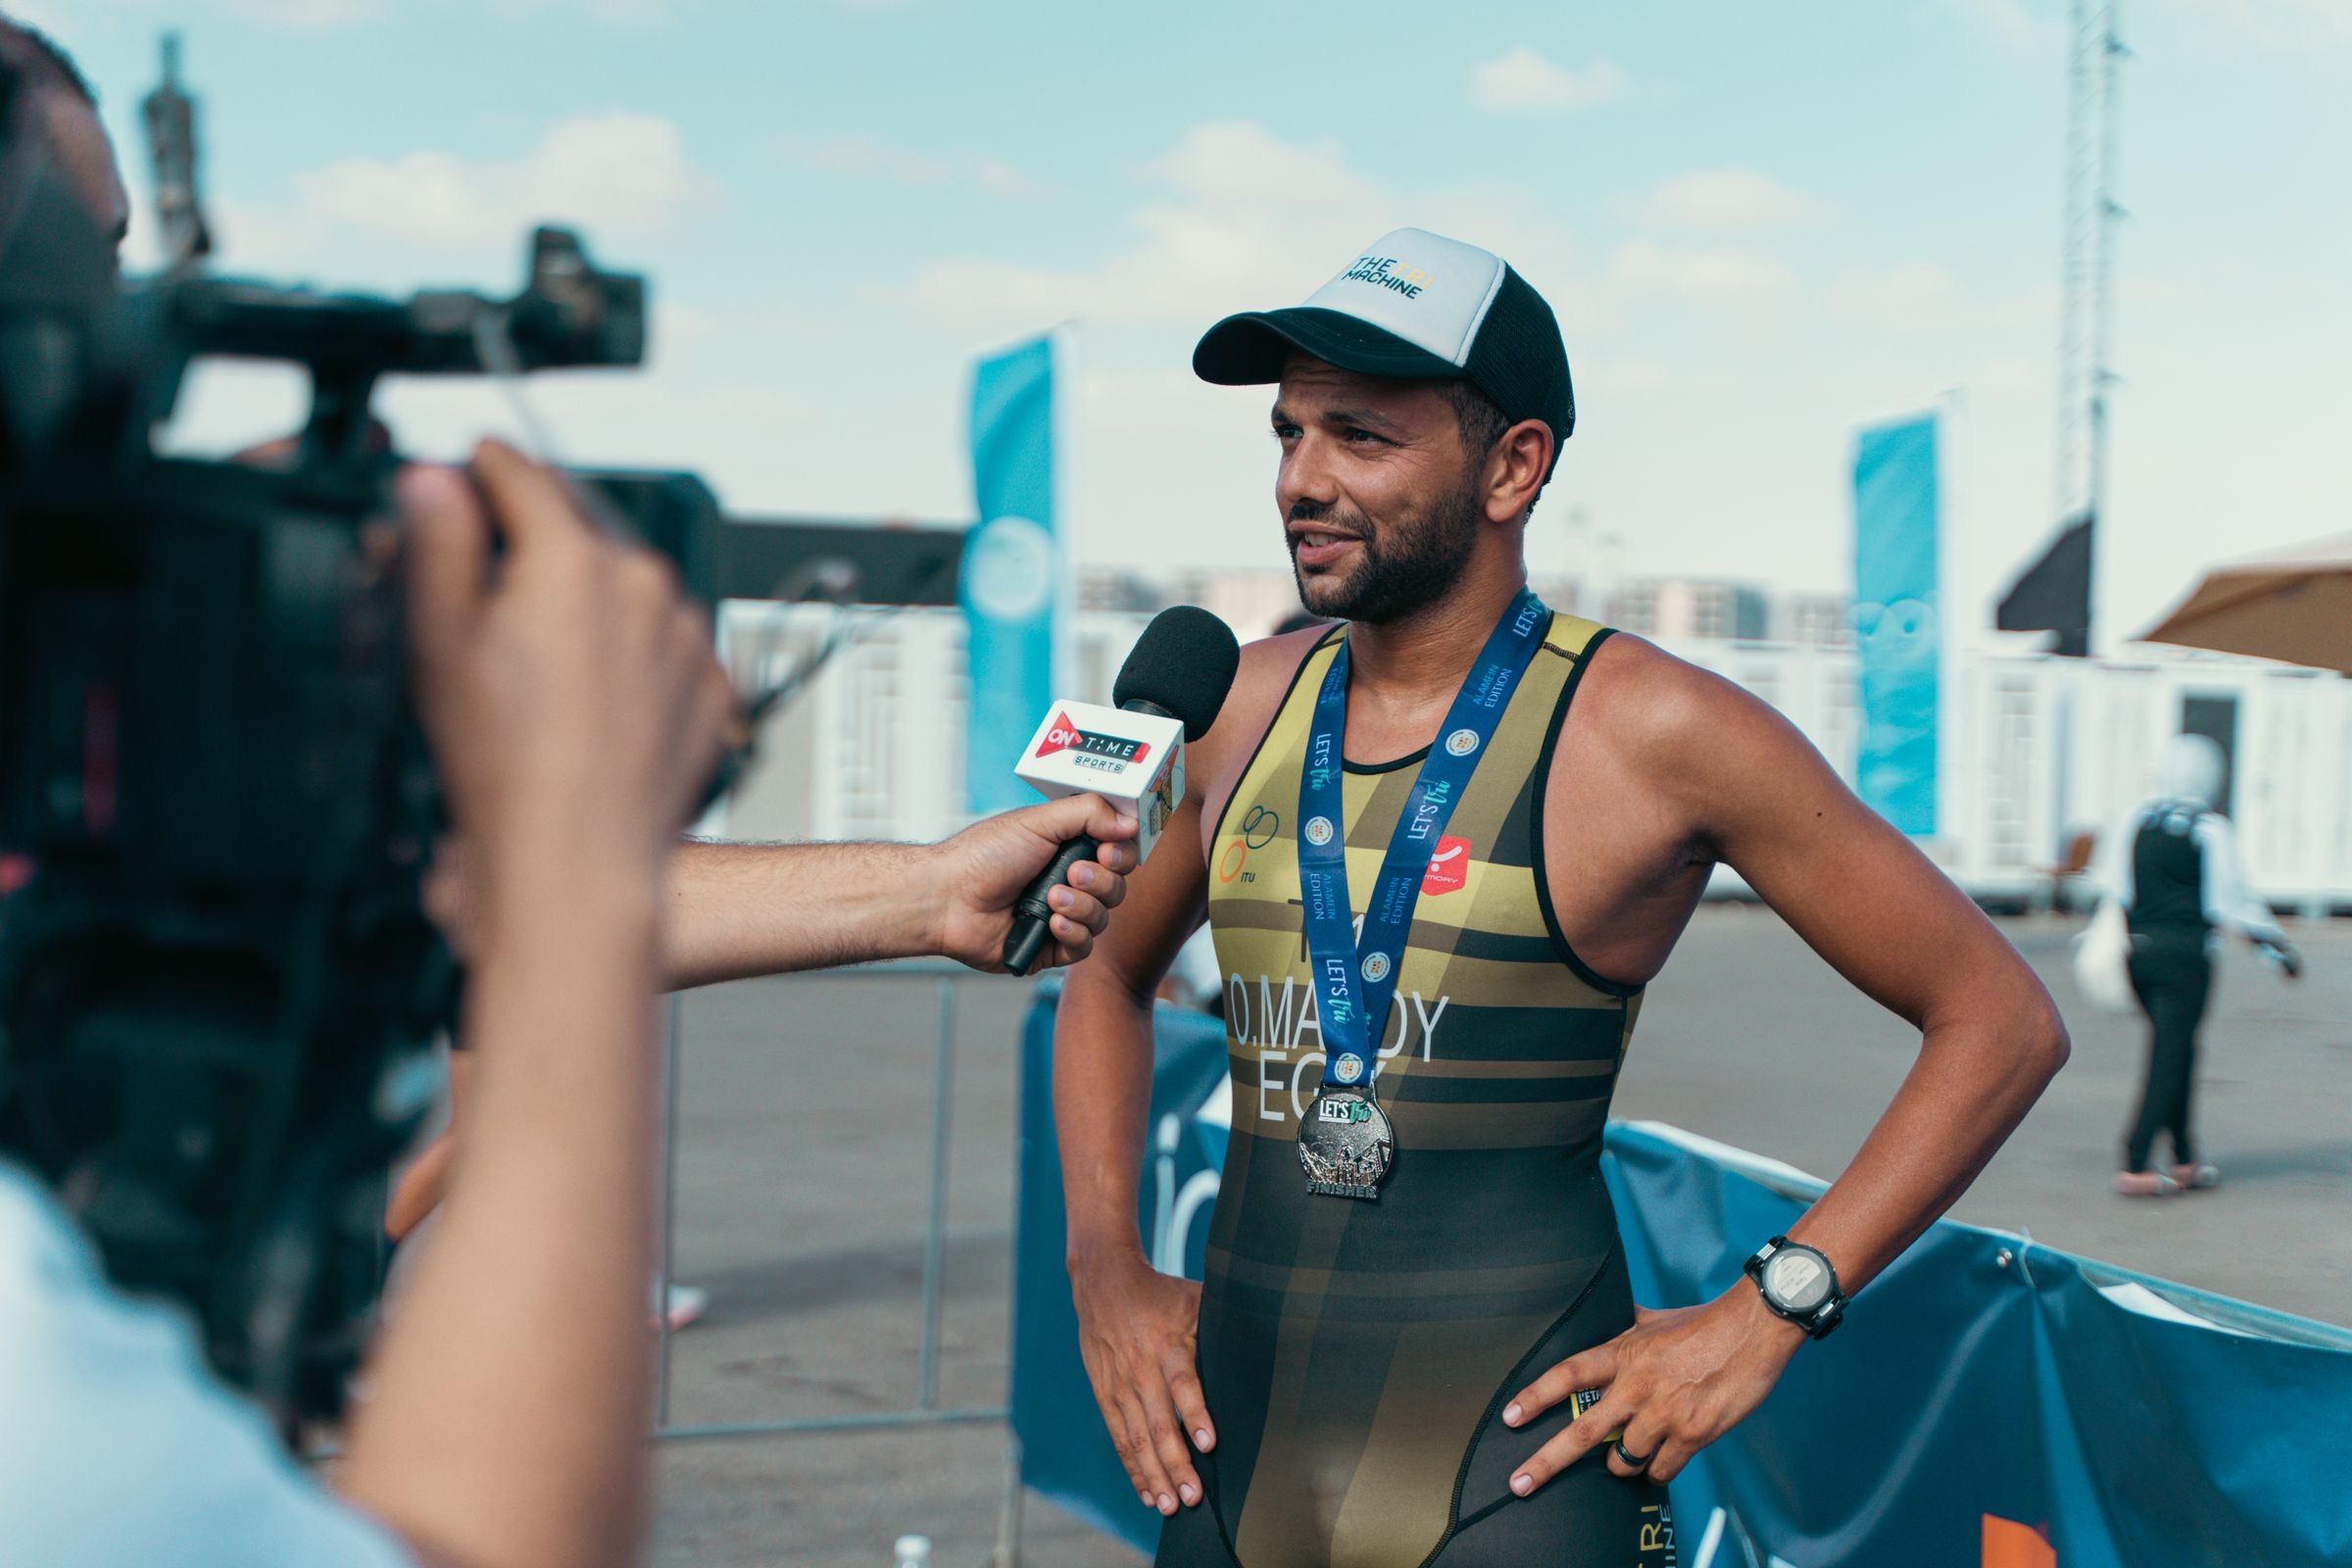
Produktionsfirmen
Interviews am Spielfeldrand, im Tunnel und in der Mixed Zone, sauber genug zum Veröffentlichen.
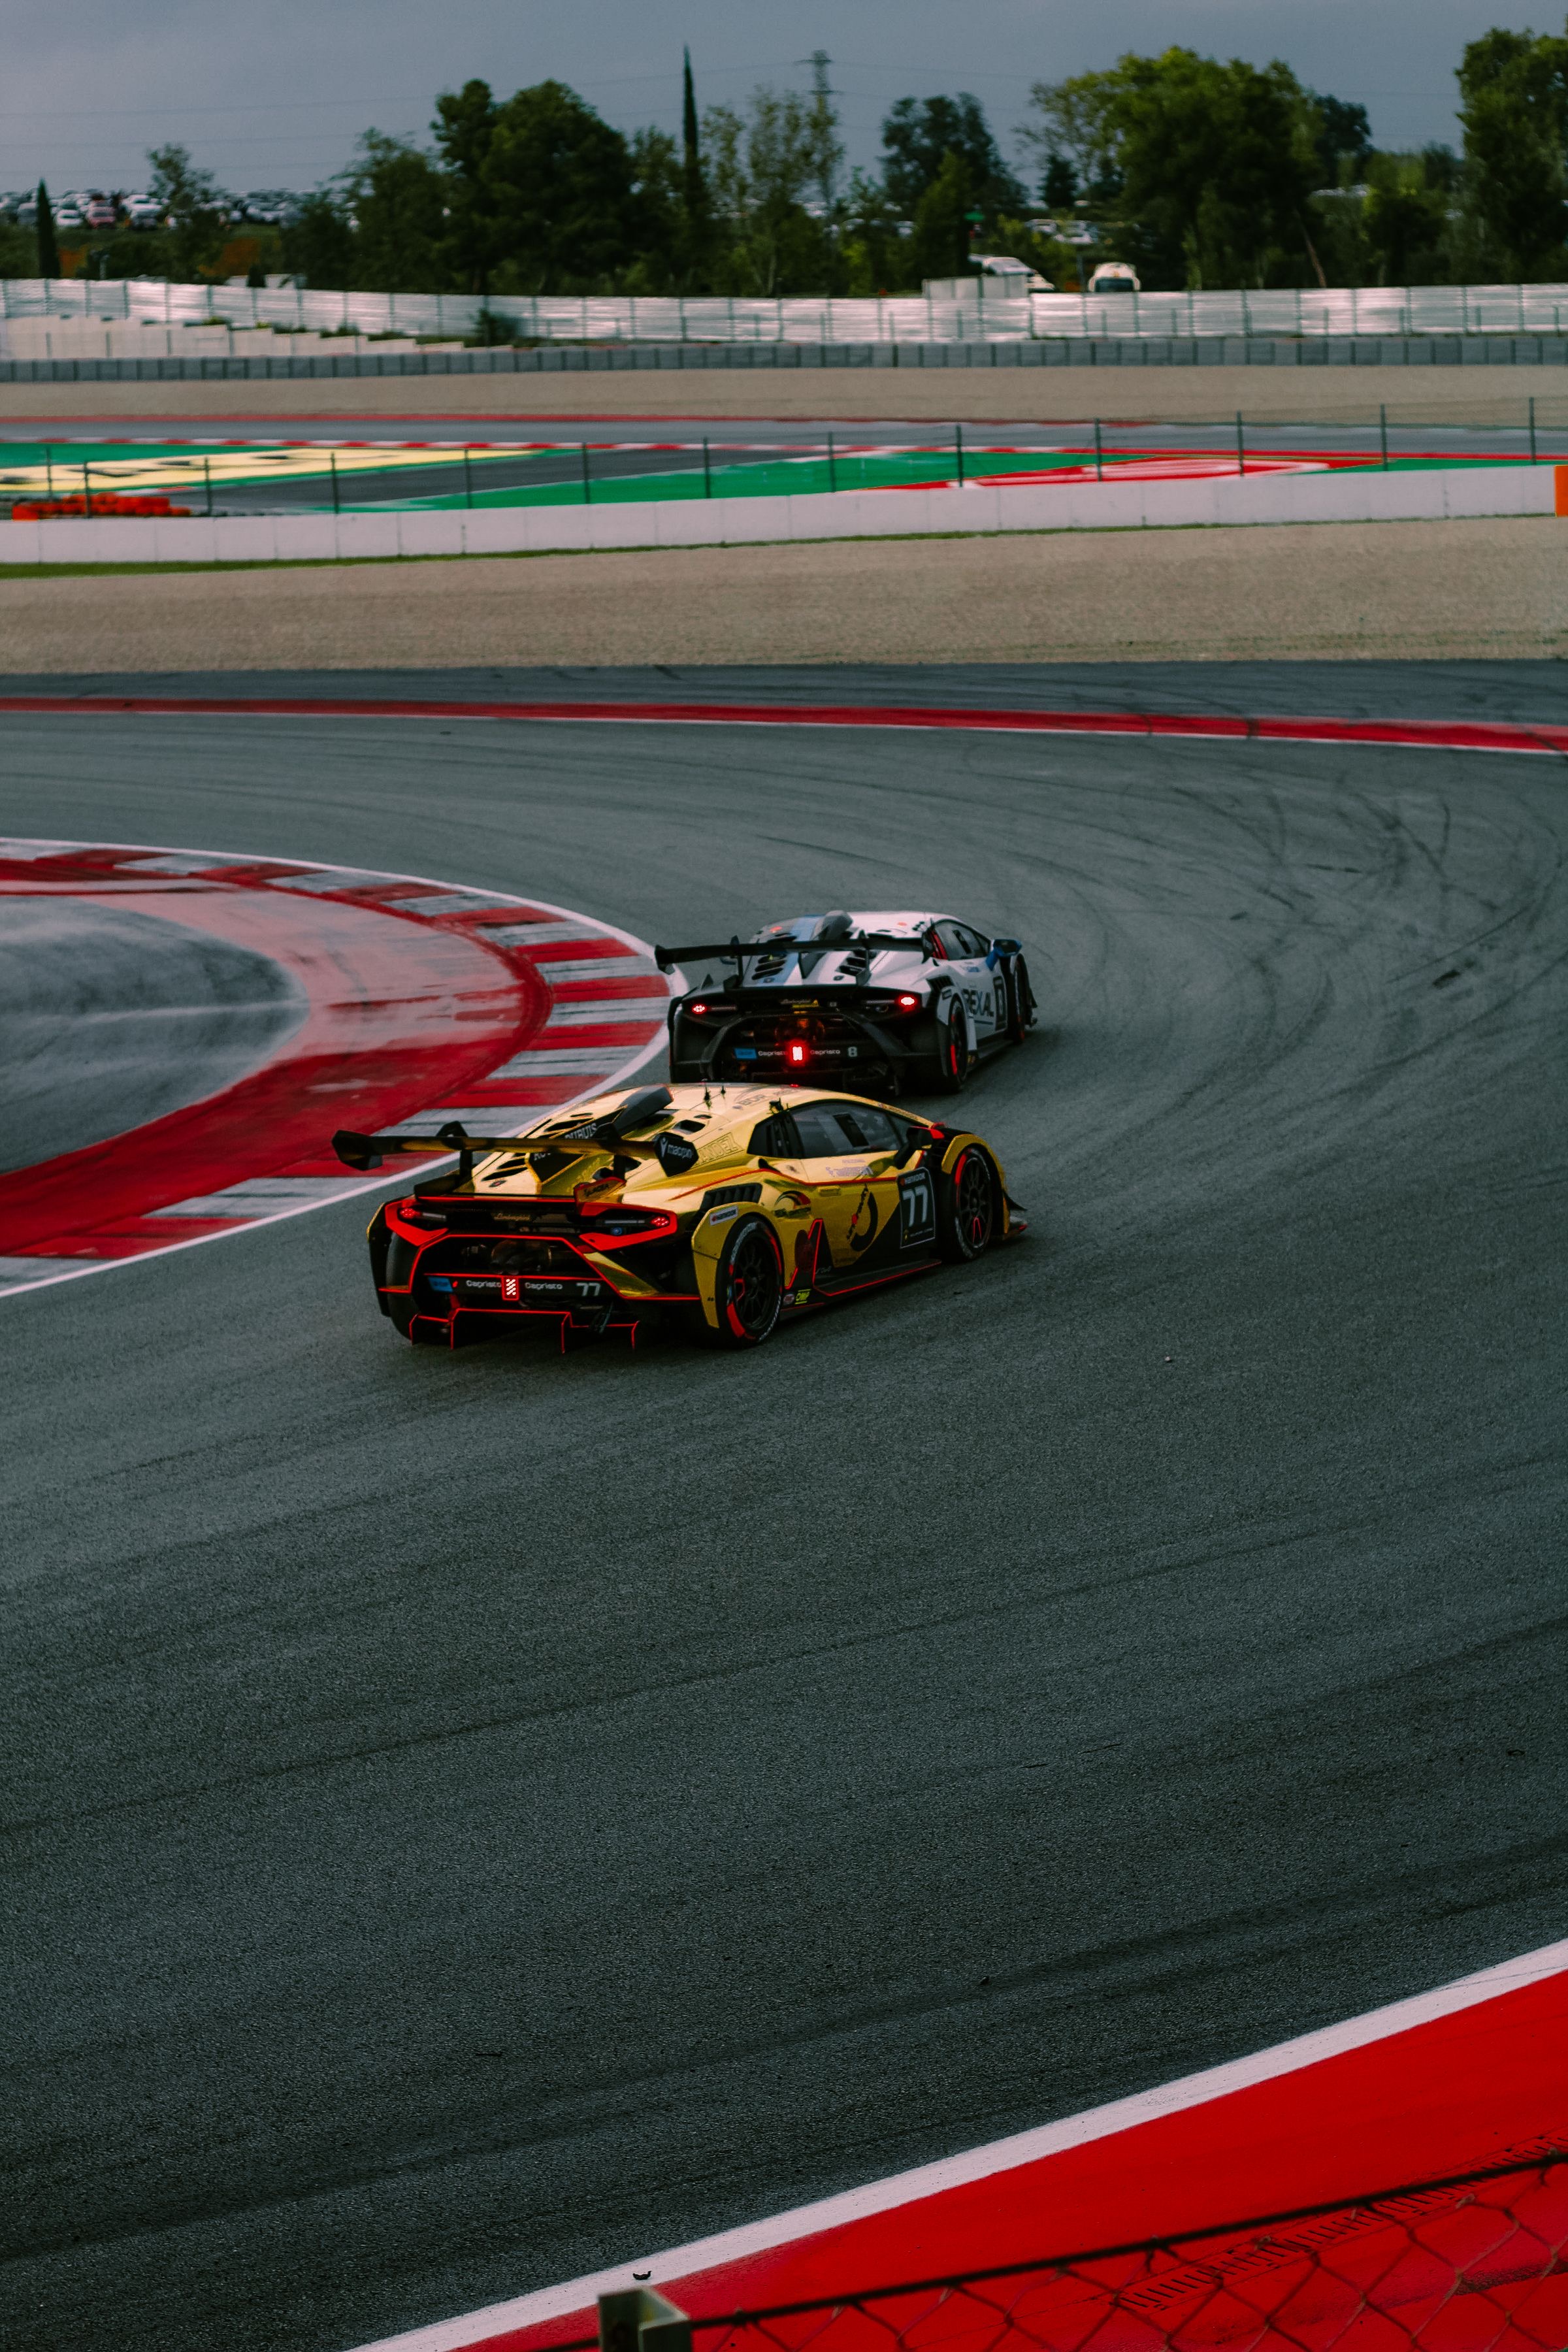
Motorsport
Motoren-, Wind- und Boxengassenlärm raus aus Fahrer- und Reporterstimmen.
Archive
Alte Spiele und Highlights, neu geschnitten mit sauberem Kommentar.
Das Problem
Die besten Momente sind die lautesten
Tore, Zieleinläufe und Boxenstopps passieren, wenn Publikum und Motoren am lautesten sind. Genau dann gehen Kommentar, Interviews und Boxenfunk unter.
Wenn Sie Hintergrundgeräusche wie Publikumslärm entfernen, bekommen Sie die Stimme zurück, ohne den Moment zu verlieren.
Trennung vs. Rauschunterdrückung
Trennen Sie die Stimme. Drehen Sie den Lärm nicht nur leiser.
| Rauschunterdrückung | Audio-Trennung von CAMB.AI | |
|---|---|---|
| Was Sie erhalten | Eine bereinigte Spur | Zwei Stems: Kommentar und Atmosphäre |
| Publikum und Motoren | In derselben Spur leiser gedreht | Auf eigenem Stem, bereit zum Remix |
| Die Atmosphäre nutzen | Nein | Ja |
Im Vergleich
Sauberer als AudioShake und ElevenLabs bei allen 8 Messgrößen
Tippen Sie auf einen Stem, um ihn zu hören
Weniger Rauschen zwischen Wörtern
vs. AudioShake
vs. ElevenLabs
Qualität
Getestet mit echtem Audio
In unserem Benchmark mit sieben echten Clips, darunter Live-TV und Interviews im Freien, ließ CAMB.AI am wenigsten Stimme im Hintergrund-Stem zurück: 0,376 %, gegenüber 0,437 % bei AudioShake und 0,447 % bei ElevenLabs.
Am wenigsten Stimme zurückgelassen
14 % weniger als AudioShake, 16 % weniger als ElevenLabs, 29 % weniger als LALAL.AI: ein Hintergrund-Stem, den Sie wirklich wiederverwenden können.
Durchschnittliche Wahrscheinlichkeit, dass im Hintergrund-Stem noch Sprache zu hören ist.
Die sauberste Stimme der vier
2,8× AudioShake und 1,7× ElevenLabs dabei, wie sauber die Stimme aus dem Mix gelöst wird.
SI-SDR, geschätzt mit SQUIM: wie viel der getrennten Stimme tatsächlich Stimme ist und nicht ihre Umgebung.
Am wenigsten Stimme zurückgelassen
14 % weniger als AudioShake, 16 % weniger als ElevenLabs, 29 % weniger als LALAL.AI: ein Hintergrund-Stem, den Sie wirklich wiederverwenden können.
Durchschnittliche Wahrscheinlichkeit, dass im Hintergrund-Stem noch Sprache zu hören ist.
Die Stimme, die am besten klingt
24 % über AudioShake und 23 % über ElevenLabs dabei, wie gut die getrennte Stimme klingt.
PESQ, geschätzt mit SQUIM: wahrgenommene Sprachqualität, ohne Referenzaufnahme.
Die Stimme, die am leichtesten zu verstehen ist
Jedes Wort bleibt klar, vor allen drei anderen.
STOI, geschätzt mit SQUIM: wie verständlich die getrennte Sprache ist.
Die meiste Stimme im Stimm-Stem
23 % über AudioShake und 13 % über ElevenLabs.
Durchschnittlicher CLAP-Sprachfokus-Abstand: wie eindeutig der Vordergrund-Stem Sprache enthält.
| Messgröße | CAMB.AI | AudioShake | ElevenLabs | LALAL.AI |
|---|---|---|---|---|
| Trennqualität (SI-SDR) | 2.84 dB | 1.01 dB | 1.64 dB | 2.81 dB |
| Stimme im Hintergrund (Leakage) | 0.376% | 0.437% | 0.447% | 0.529% |
| Wahrgenommene Qualität (PESQ) | 1.895 | 1.527 | 1.544 | 1.852 |
| Verständlichkeit (STOI) | 0.744 | 0.697 | 0.726 | 0.740 |
| Stimme im Vordergrund (CLAP gap) | 0.258 | 0.209 | 0.229 | 0.255 |
| DNSMOS Sprachqualität (SIG) | 2.662 | 2.387 | 2.523 | 2.684 |
| DNSMOS Hintergrundqualität (BAK) | 2.884 | 2.307 | 2.538 | 2.973 |
| DNSMOS Gesamtqualität (OVRL) | 2.303 | 1.923 | 2.094 | 2.327 |
Interner Benchmark: CAMB.AI, AudioShake, ElevenLabs und LALAL.AI mit denselben sieben Clips von Wikimedia Commons (Gaming-Kommentar, ein Filmtrailer, Livemusik, ein Interview im Freien, ein Live-Newsroom, Archiv-TV und ein Red-Carpet-Interview), gemittelt. SQUIM und DNSMOS sind referenzfreie Schätzungen. Bei den drei DNSMOS-Werten liegt LALAL.AI knapp vorn; bei allen anderen Messgrößen führt CAMB.AI.
Anwendungsfälle
Kommentar isolieren, vom Stadion bis zur Rennstrecke
Was Sie erhalten
Zwei Stems aus jedem Feed
Stimme
Kommentar, Field-Reporter, Interviews nach dem Spiel, Stimmen von Fahrern und Teams.
Atmosphäre
Publikum, Fangesänge, Motoren, Stadiondurchsagen und Stadionsound, ohne die Stimme darüber. Alles, was nicht Stimme ist, bleibt gemeinsam im Atmosphäre-Stem, auch Musik.
Gemacht für Live-Sport-AudioEnterprise
Ihr Live-Feed, zurück als Stimme und Atmosphäre in zwei getrennten Streams, in Echtzeit. Eine Enterprise-Funktion, auf Anfrage mit Ihrem Team eingerichtet.
Sprechen Sie mit unsNach dem Spiel
Laden Sie Aufnahmen hoch und laden Sie beide Stems als FLAC, WAV, MP3 oder AAC herunter.
API
Automatisieren Sie es in Ihrem Produktions-Workflow.
POST /apis/audio-separationGET /apis/audio-separation/{task_id}GET /apis/audio-separation-result/{run_id}POST /apis/audio-separation-resultsZur API für Audio-Trennung
Mehr Audio-Trennung
So funktioniert es
Hintergrundgeräusche entfernen in drei Schritten
Preise
Wählen Sie Ihre Stunden. Beide Stems in jedem Tarif.
Jeder Tarif liefert Stimme und Hintergrund als zwei Stems, in Studio und per API. Testen Sie jeden Tarif 3 Tage kostenlos, mit 30 Minuten Audio.
Solo
$40/Monat
$480 jährlich abgerechnet
3 Stunden Audio pro Monat
Für Creator und Hobbyisten. Holen Sie die Stimme in Minuten aus Songs, Podcasts und Videos.
Kostenlos testen- Heute 30 Minuten zum Testen. Heute $0.
- Tag 3 Ihr Tarif beginnt: $480 pro Jahr.
Session
Empfohlen$130/Monat
$1,560 jährlich abgerechnet
10 Stunden Audio pro Monat
Für Produzenten und Content Creator, die jede Woche arbeiten. Genug für ganze Alben, Podcasts und Soundtracks.
Kostenlos testen- Heute 30 Minuten zum Testen. Heute $0.
- Tag 3 Ihr Tarif beginnt: $1,560 pro Jahr.
Catalog
$375/Monat
$4,500 jährlich abgerechnet
30 Stunden Audio pro Monat
Für Profis und Teams mit hohem Volumen. Saubere Stimm- und Hintergrund-Stems für Musik, Postproduktion und Lokalisierung.
Kostenlos testen- Heute 30 Minuten zum Testen. Heute $0.
- Tag 3 Ihr Tarif beginnt: $4,500 pro Jahr.
Enterprise
Hohe Volumen, Live-Trennung auf Ihren eigenen Feeds oder Trennung direkt in Ihrem eigenen Workflow.
- Live-Trennung in Echtzeit
- Volumenpreise
- SLA und dedizierter Support
- Individuelle Auslieferung und Speicherung
FAQ
Fragen zur Audio-Trennung im Sport
Hören Sie Ihr eigenes Spiel, getrennt
- SOC-2-konform
- Ihr Audio wird nicht zum Training unserer Modelle verwendet
- Batch und live