Speech-to-Text-API

Speech-to-Text-API für aufgezeichnetes und Echtzeit-Audio

Senden Sie eine Datei und erhalten Sie ein Transkript mit Sprecherkennzeichnung und Zeitstempeln. Streamen Sie Live-Audio und erhalten Sie den Text, während gesprochen wird. 150+ Sprachen, automatisch erkannt.

call-en.mp30:13 / 0:13
Python
from camb.client import CambAI​client = CambAI()  # reads CAMB_API_KEYjob = client.transcription.create_transcription(media_url="https://example.com/call-en.mp3",language="auto",)print(job.task_id)
Ergebnis200 OK

Eine API für jede Art, Sprache zu erfassen

Die Speech-to-Text-API von CAMB.AI wandelt gesprochenes Audio per automatischer Spracherkennung (ASR) in Text um. Senden Sie aufgezeichnete Dateien für vollständige Transkripte oder streamen Sie Audio für Live-Text. Ein API-Schlüssel für beides, aus Ihrem eigenen Code oder aus Studio.

Sie suchen eine Spracherkennungs-API, die in Ihrer App läuft und nicht nur im Browser? Hier ist sie.

Aufgezeichnete Dateien oder Echtzeit-Audio

Batch

Transkriptions-API für aufgezeichnete Dateien

Laden Sie eine Datei hoch oder senden Sie eine URL. Sie erhalten den Text nach Sprechern getrennt, mit Start- und Endzeit für jede Zeile. Export als JSON, SRT, VTT oder TXT.

Uploads bis 20 MB. Für längere Aufnahmen senden Sie eine URL.

  • MP3
  • WAV
  • AAC
  • FLAC
  • MP4
  • MOV

Echtzeit

Echtzeit-Speech-to-Text-API über WebSocket

Eine Streaming-Speech-to-Text-API für Entwickler: Öffnen Sie einen WebSocket, streamen Sie Roh-Audio aus Ihrer App und erhalten Sie Teiltranskripte, während noch gesprochen wird, danach ein Endergebnis mit Zeitstempeln pro Wort. Gemacht für Live-Untertitel, Sprach-Apps und KI-Agenten.

  • WebSocket
  • PCM
  • A-law
  • μ-law

Sprechererkennung bei jeder aufgezeichneten Datei

Die API erkennt, wer wann spricht, und kennzeichnet jede Zeile: Sprecher 1, Sprecher 2. Das ist im schnellen und im langsamen Modus eingebaut, ohne etwas einschalten zu müssen. So kommen Interviews, Meetings und Podcasts lesefertig zurück.

Gemacht für echtes Audio

  • Erst wird das Audio bereinigt

    Die Stimme wird vor der Transkription von Hintergrundgeräuschen getrennt, und Sie entscheiden, ob die Musik bleibt. Für saubere Studioaufnahmen schalten Sie es aus.

  • Automatische Spracherkennung

    Stellen Sie die Sprache auf auto, und die API erkennt sie für Sie, in 150+ Sprachen.

  • Schnell oder gründlich

    Nutzen Sie standardmäßig den schnellen Modus oder den langsamen Modus für einen gründlicheren Durchlauf.

  • Untertitelfertige Ausgabe

    Legen Sie die maximale Länge und Anzeigedauer jeder Zeile fest und exportieren Sie SRT oder VTT.

  • Zeitstempel pro Wort

    Endgültige Echtzeit-Ergebnisse enthalten eine Start- und Endzeit für jedes Wort.

  • Ergebnisse gebündelt

    Rufen Sie die Transkripte vieler Durchläufe mit einer Anfrage ab.

Speech-to-Text im Broadcast-Maßstab

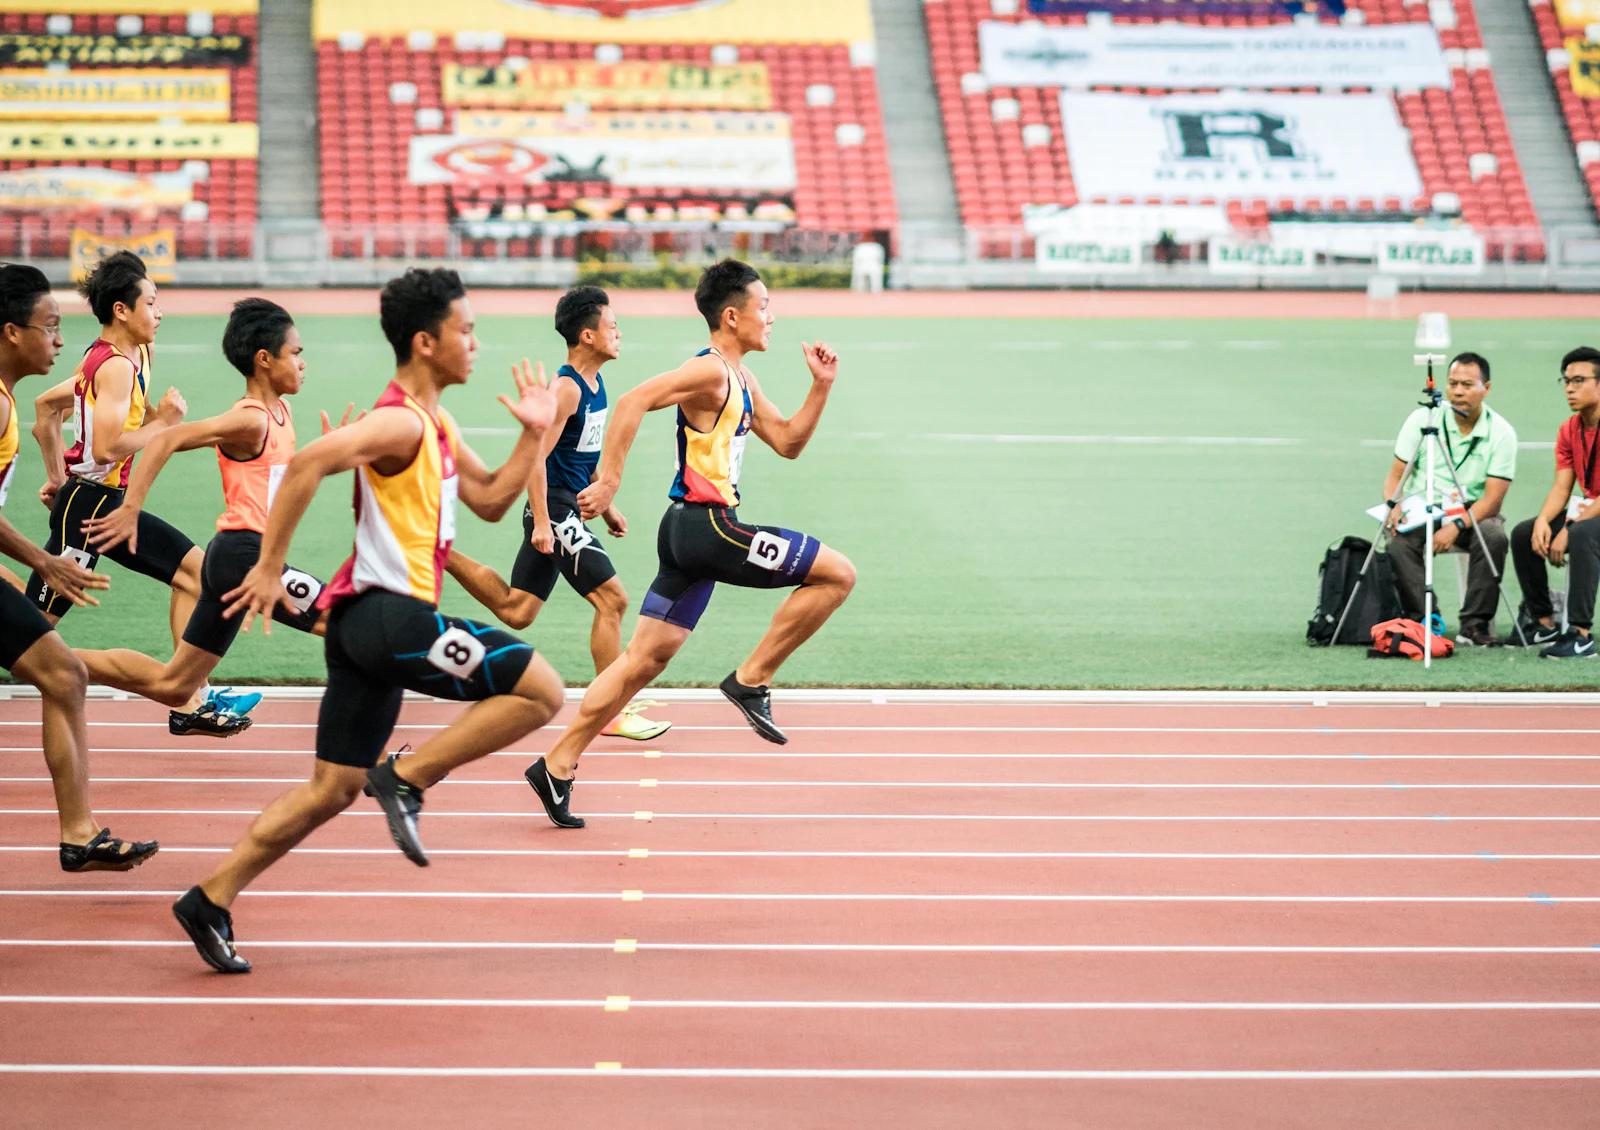
Sprinters racing on an athletics track

Echtzeit-Speech-to-Text für die Paralympischen Winterspiele Milano Cortina 2026

“Mit Echtzeit-Untertiteln für jeden Wettbewerb auf Eurovision Sport bauen wir digitale Barrierefreiheit aus und sorgen dafür, dass mehr Menschen das Geschehen live verfolgen können.”

Alan Fagan, Managing Director, Eurovision Sport
6
paralympische Sportarten in Echtzeit untertitelt
10 Tage
Live- und On-Demand-Berichterstattung, 6.–15. März 2026
2024
Beginn der Partnerschaft, zuerst mit European Athletics

Zur Fallstudie

Speech-to-Text-API in Python und TypeScript

Installieren Sie das SDK, fügen Sie Ihren API-Schlüssel hinzu und senden Sie Ihre erste Datei. SDKs für Python und TypeScript (JavaScript), dazu Go, Java, Rust und PHP für aufgezeichnete Dateien.

  • Python
  • TypeScript
  • Go
  • Java
  • Rust
  • PHP

Zur Dokumentation

from camb.client import CambAI​client = CambAI()  # reads CAMB_API_KEYjob = client.transcription.create_transcription(media_url="https://example.com/meeting.mp3",language="auto",)print(job.task_id)
Antwort200 OK
{ "transcript": [{ "start": 5.0, "end": 12.0,"text": "Welcome to our discussion on AI.","speaker": "SPEAKER_0" },{ "start": 13.0, "end": 18.0,"text": "Thank you for having me.","speaker": "SPEAKER_1" }] }

Einmal transkribieren, überall nutzen

Ihr Transkript endet nicht beim Text. Auf CAMB.AI wird dasselbe Transkript zu Untertiteln, einer Übersetzung oder einer synchronisierten Fassung, auf derselben Plattform. Sie brauchen Transkripte ohne Code, aus einer Datei oder live vom Mikrofon? Nutzen Sie unser Transkriptions-Tool in Studio.

Fragen zur Speech-to-Text-API

Eine Speech-to-Text-API (auch Voice-to-Text- oder Transkriptions-API genannt) lässt Ihre Software Audio senden und Text zurückerhalten. Die API von CAMB.AI verarbeitet aufgezeichnete Dateien und Echtzeit-Audiostreams.

Die Batch-Transkriptions-API arbeitet mit aufgezeichneten Dateien: Sie senden eine Datei oder URL und holen das vollständige Transkript ab, sobald es fertig ist. Die Echtzeit-API streamt Audio über einen WebSocket und liefert Text, während gesprochen wird.

Ja, bei aufgezeichneten Dateien. Jede Zeile des Transkripts erhält eine Sprecherkennzeichnung (Sprecher 1, Sprecher 2) sowie eine Start- und Endzeit. Die Echtzeit-API trennt Sprecher noch nicht.

150+ Sprachen und regionale Varianten. Übergeben Sie einen Sprachcode oder stellen Sie die Sprache auf auto, um sie erkennen zu lassen.

In Echtzeit ja: Jedes Endergebnis enthält eine Start- und Endzeit für jedes Wort. Aufgezeichnete Dateien liefern eine Start- und Endzeit für jede Zeile des Transkripts.

MP3, WAV, AAC, FLAC, MP4 und MOV. Laden Sie Dateien unter 20 MB hoch oder senden Sie für längere Aufnahmen eine URL. In Echtzeit streamen Sie Roh-Audio (PCM, A-law oder μ-law) über den WebSocket.

Ja. Installieren Sie camb-sdk mit pip und erstellen Sie eine Transkription in wenigen Zeilen. Es gibt auch ein TypeScript-SDK (@camb-ai/sdk). Die Echtzeit-API ist in den SDKs für Python und TypeScript enthalten; die SDKs für Go, Java, Rust und PHP decken aufgezeichnete Dateien ab.

Ja. Laden Sie das Transkript als SRT, VTT oder TXT mit Sprechernamen herunter und legen Sie die maximale Länge jeder Untertitelzeile fest.

Standardmäßig trennt die API die Stimme vor der Transkription von Hintergrundgeräuschen, und Sie können auch die Musik entfernen lassen. Sauberes Audio liefert weiterhin die besten Ergebnisse, und für Sprache in Studioqualität können Sie die Bereinigung ausschalten.

Senden Sie noch heute Ihre erste Datei

  • SOC 2-konform
  • Frühere Durchläufe bleiben in Ihrer History
  • Aufgezeichnete Dateien und Echtzeit